

Аппроксимационная модель течения газа через штуцер#
В данном практическом руководстве представлены шаги реализации модели машинного обучения, предназначенной для аппроксимации процесса течения газа через штуцер, а также представлен способ применения ML модели на платформе REPEAT VISION.
Примечание
Если вы не обладаете базовыми навыками использования библиотеки Пневматика платформы REPEAT VISION, то ознакомьтесь с вводным уроком перед тем, как продолжить выполнение данного практического руководства.
1. Моделирование течения газа в простой трубопроводной системе#
Для того, чтобы сосредоточить внимание на процессе создания модели машинного обучения, необходимо подготовить модель простой трубопроводной системы для расчёта течения газа через штуцер. Схема необходимого проекта представлена на рисунке ниже.
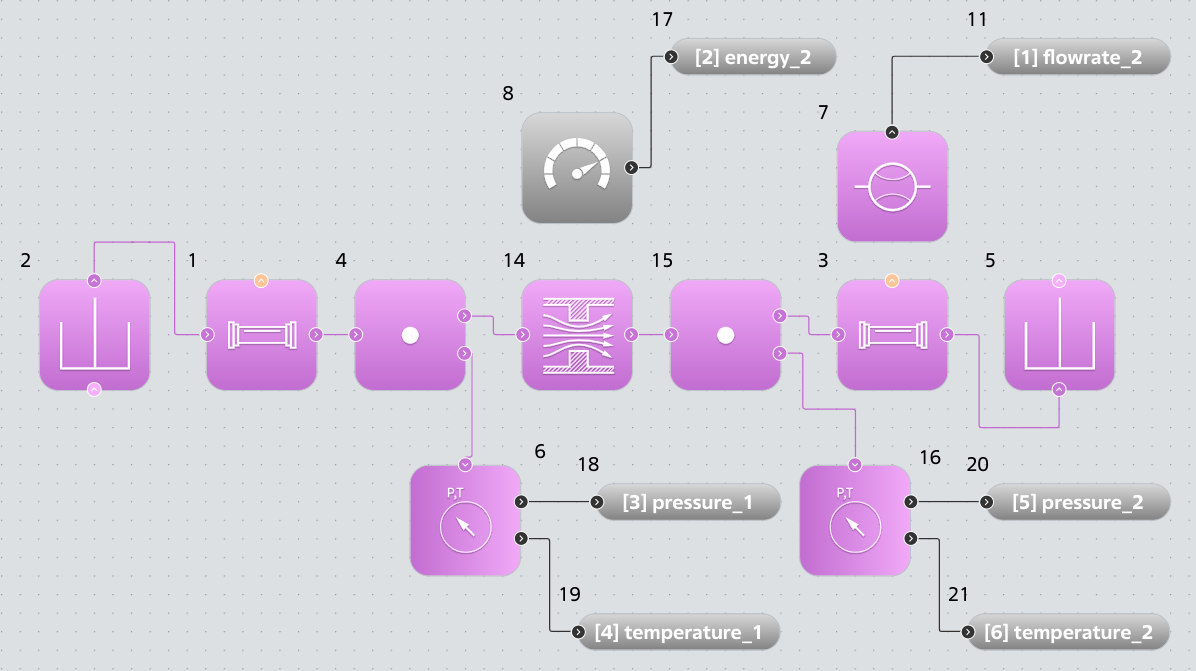
Простая трубопроводная система для моделирования течения газа через штуцер.#
Изображённый выше проект позволяет исследовать изменение массового расхода газа и потока энергии через штуцер - блок №14 Аппроксимационная модель (П) - при изменении параметров, приведённых в таблице ниже.
Параметр |
Тип параметра |
Имя глобальной переменной |
Значение |
Применяется к блоку |
|---|---|---|---|---|
Давление в резервуаре |
Граничное условие \([Па]\) |
PRESS |
7.5e6 |
Блок |
Температура |
Граничное условие \([^{\circ}C]\) |
TEMP |
20.0 |
Резервуары (П) |
Блоки резервуаров (П) №2 и №5 обладают следующими настройками:
Свойство |
Блок |
Блок |
|---|---|---|
Избыточное давление \([Па]\) |
5e6 |
|
Температура \([^{\circ}C]\) |
||
Площадь сечения портов \([м^2]\) |
0.2 |
0.2 |
Блоки участков трубопроводов (П) №1 и №3 содержат следующие настройки:
Свойство |
Значение |
|---|---|
Сжимаемость газа |
Не учитывается |
Длина трубы \([м]\) |
5 |
Диаметр трубы \([м]\) |
0.2 |
Начальная температура газа в трубе \([^{\circ}C]\) |
Другие настройки блоков №1 и №3 используются, заданными по умолчанию.
Подсказка
Допускается не учитывать сжимаемость газа при моделировании коротких участков трубопроводов.
Блок №14 отверстие (П) предназначен для моделирования штуцера в трубопроводной системе. Блок обладает следующими настройками:
Свойство |
Значение |
|---|---|
Тип отверстия |
Постоянный |
Площадь сечения потока вне отверстия \([м^2]\) |
0.126 |
Площадь сечения отверстия \([м^2]\) |
0.02 |
Другие настройки блока №14 используются, заданными по умолчанию.
Блоки датчиков давления и температуры (П) №6 и №16 измеряют параметры потока газа и обладают следующими настройками:
Свойство |
Значение |
|---|---|
Тип датчика |
Абсолютный |
Давление |
Значение передаётся на выходной порт |
Температура |
Значение передаётся на выходной порт |
Датчик №6 должен выводить значения давления и температуры в блоки выходных портов №18 и №19 с пользовательскими названиями pressure_1 и temperature_1 соответственно.
Датчик №16 должен выводить значения давления и температуры в блоки выходных портов №20 и №21 с пользовательскими названиями pressure_2 и temperature_2 соответственно.
Результаты расчёта потенциалов:
Давлений:
pressure_1иpressure_2,Температур:
temperature_1иtemperature_2
будут использованы в качестве входных параметров модели машинного обучения для аппроксимации массового расхода и потока энергии на штуцере - блок №14 отверстие (П) - трубопроводной системы.
Датчик №8 должен выводить значение потока энергии \([Вт]\), измеренного в отверстии (П) №14, в выходной порт №17 с пользовательским названием energy_2.
Датчик расхода (П) №7 должен выводить значение массового расхода \([кг/c]\), измеренного на участке трубопроводов (П) №3, в выходной порт №11 с пользовательским названием flowrate_2.
Результаты расчёта потоков: массового расхода flowrate_2 и потока энергии energy_2, - будут аппроксимированы моделью машинного обучения и будут выдаваться в качестве соответствующих результатов на выходных портах блока Аппроксимационная модель (П).
В проекте должны использоваться следующие настройки:
Время моделирования \([с]\) |
Шаг интегрирования \([мс]\) |
Шаг дискретизации \([мc]\) |
|---|---|---|
1 |
5 |
100 |
1.1. Требование к формулированию задачи для подготовки модели машинного обучения#
Принимая во внимание требования к модели машинного обучения с целью дальнейшей интеграции на платформу REPEAT VISION для взаимодействия с блоками библиотеки Пневматика далее описывается случай формулирования задачи, в которой поток энергии energy_2 и массовый расход flowrate_2 положительно направлены от участка трубопровода (П) №1 с граничными условиями температуры temperature_1 и давления pressure_1 к участку трубопровода (П) №3 с граничными условиями температуры temperature_2 и давления pressure_2. Данный случай отдельно описан в справке блока Аппроксимационная модель (П) и выглядит следующим образом.
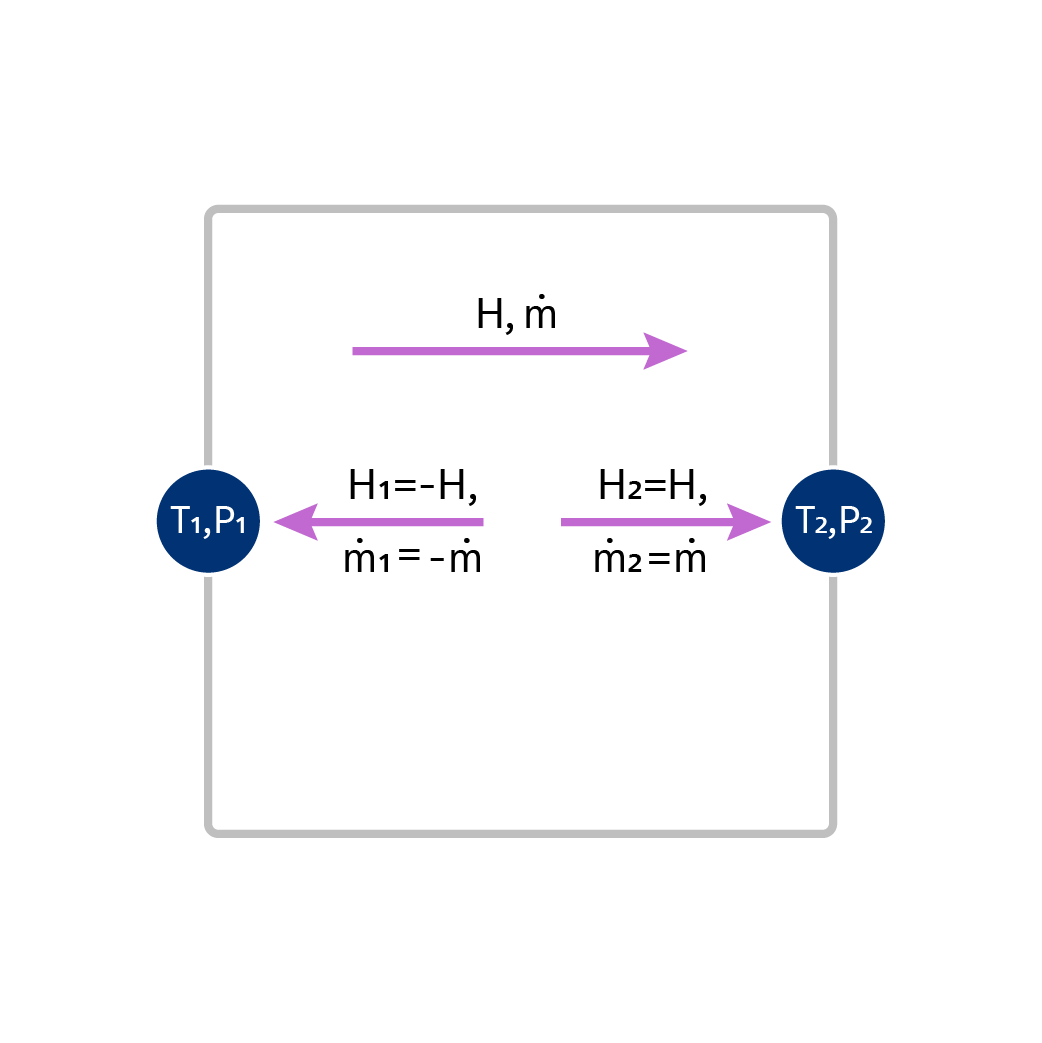
Расчёт потока энергии и массового расхода от узла 1 к узлу 2 аппроксимационной модели с двумя узлами.#
На схеме выше приняты следующие обозначения.
Обозначения |
Описание |
|---|---|
T₁,P₁ |
Узел модели с граничными условиями температуры |
T₂,P₂ |
Узел модели с граничными условиями температуры |
H, \(\dot{\mathbf m}\) |
Положительное направление потока энергии energy_2 и массового расхода flowrate_2 модели |
При подготовке данных расчёта потоков энергии и массовых расходов в рамках параметрических исследований необходимо создать:
Дополнительный поток энергии energy_1, равный отрицательному значению energy_2,
Дополнительный массовый расход flowrate_1, равный отрицательному значению flowrate_2 в соответствии со схемой, приведённой выше.
2. Подготовка к работе#
Примечание
Вы можете скачать файл Jupyter ноутбука, а также данные для обучения ML модели, если хотите быстро выполнить данный урок на вашем персональном компьютере.
Также вы можете скачать ONNX файл ML модели и сразу использовать её в проекте на платформе REPEAT VISION с помощью блока Аппроксимационная модель (П).
Вся последующая работа подготовки данных и создания ML модели должна выполняться на локальной машине с использованием фреймворка PyTorch. Работу предлагается выполнять в Jupyter.
Перед началом работы необходимо установить:
Python пакет repeat, необходимый для взаимодействия с платформой REPEAT VISION;
Пакет repeat_onnx для подготовки дополнительного описания ML модели с целью её интеграции на платформу REPEAT VISION через блок
Аппроксимационная модель (П);Пакеты для работы с данными и создания ML модели: PyTorch, Scikit-learn, Pandas, ONNX, Matplotlib, tqdm, Jupyter.
В командной строке вашего компьютера необходимо выполнить следующие команды и продолжить работу в Jupyter ноутбуке.
mkdir ml_gas_flow
cd ml_gas_flow
python -m venv repeat_ml.
source repeat_ml/bin/activate
python -m pip install repeat repeat_onnx torch scikit-learn pandas onnx matplotlib tqdm jupyterlab ipywidgets
jupyter lab
mkdir ml_gas_flow
cd ml_gas_flow
python -m venv repeat_ml.
repeat_ml\Scripts\Activate.ps1
python -m pip install repeat repeat_onnx torch scikit-learn pandas onnx matplotlib tqdm jupyterlab ipywidgets
jupyter lab
См. также
Более подробную информацию о работе с Python на локальной машине для взаимодействия с платформой REPEAT VISION вы можете найти в наших уроках:
В первой ячейке вашего ноутбука выполните импорт Python пакетов, необходимых для подготовки данных и обработки результатов расчётов, а также Python пакет repeat с модулем параметрических исследований.
import matplotlib.pyplot as plt
import numpy as np
import onnx
import pandas as pd
import repeat as rp
import repeat.parametric_study as ps
import repeat_onnx as rx
import torch
from pprint import pp
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from torch import nn
from torch import optim
from torch.optim.lr_scheduler import ReduceLROnPlateau
from tqdm.notebook import tqdm
3. Подготовка описания модели#
В соответствии с необходимой схемой ML модели в следующей ячейке создаётся описание пневматической модели машинного обучения с помощью пакета repeat_onnx для обеспечения последующей интеграции ML модели на платформу REPEAT VISION через блок Аппроксимационная модель (П).
1node_1 = rx.NodeP(
2    "Input_unit", "pressure_1", "temperature_1", "flowrate_1", "energy_1"
3)
4node_2 = rx.NodeP(
5    "Output_unit", "pressure_2", "temperature_2","flowrate_2", "energy_2"
6)
7model_info = rx.ModelP([node_1, node_2])
8pp(model_info)
Строки 1-3. Создаётся описание узла №1 ML модели с помощью класса NodeP. Узлу назначается имя
"Input_unit", которое будет отображаться в свойствах порта блокаАппроксимационная модель (П). Аргументам передаются имена давления и температуры"pressure_1","temperature_1"узла модели, а также имена массового расхода и потока энергии"flowrate_1","energy_1".Строки 4-6. Создаётся описание узла №2 ML модели с помощью класса NodeP. Второму узлу назначается имя
"Output_unit". Аргументам передаются имена потенциалов и потоков аналогично первому узлу.Строка 7. Для описания пневматической модели машинного обучения создаётся экземпляр класса ModelP, включающий список из двух узлов.
Описание ML модели model_info будет использовано на всех последующих этапах: подготовки данных, создания модели и её экспорта в нейтральный формат ONNX.
4. Подготовка данных#
Примечание
Вы можете скачать файл Jupyter ноутбука если хотите быстро выполнить этап подготовки данных на вашем персональном компьютере.
Для последующего создания модели машинного обучения, аппроксимирующей работу штуцера, необходимо подготовить набор данных (расчётных случаев), включающий:
Граничные условия на штуцере трубопроводной системы:
Давления:
"pressure_1""pressure_2"
Температуры:
"temperature_1""temperature_2"
Результаты вычислений для каждого расчётного случая:
Массовый расход газа:
"flowrate_1""flowrate_2"
Поток энергии:
"energy_1""energy_2"
Для подготовки необходимого набора данных потребуются алгоритмы выполнения параметрических исследований на модели течения газа в трубопроводной системе.
Далее кратко описаны основные шаги расчёта набора массовых расходов, и потоков энергии на сетке параметров давлений и температур модели штуцера.
Сначала требуется настроить подключение к платформе REPEAT и выбрать модель для выполнения параметрических исследований.
user = rp.User(
    "enter a unique API key from REPEAT VISION user cabinet instead of this comment"
)
app = rp.Application(user)
# enter a project ID from REPEAT VISION application instead of 12345
project = 12345
t_interval = rp.TimeInterval(start = 900, end = 1000)
model = app.get_exploration_model(project, t_interval)
print(model, model.existing_variables, sep = "\n")
Для подготовки набора значений исходных данных в следующей ячейке создайте словарь variable_bounds и с помощью функции get_latin_hypercube создайте разреженный набор значений для глобальных переменных PRESS и TEMP модели трубопроводной системы.
variable_bounds = dict(
        PRESS = [6.5e6, 9.5e6],
        TEMP  = [10., 30.],
    )
input_data = ps.get_latin_hypercube(
    model,
    variable_bounds,
    seed = 42,
    sample_size = 800,
    strength = 1,
    optimization = "lloyd"
)
figure, axis = plt.subplots(dpi = 100)
input_data.plot.scatter(x = "TEMP", y = "PRESS", c = "tab:green", marker = ".", ax = axis)
axis.set_xlabel("TEMP $[^{\circ}C]$")
axis.set_ylabel("PRESS $[Pa]$")
В результате выполнения кода ячейки, приведённой выше, будет подготовлена таблица значений исходных данных input_data, а также будет выведен график распределения разреженного набора значений параметров давлений и температур.
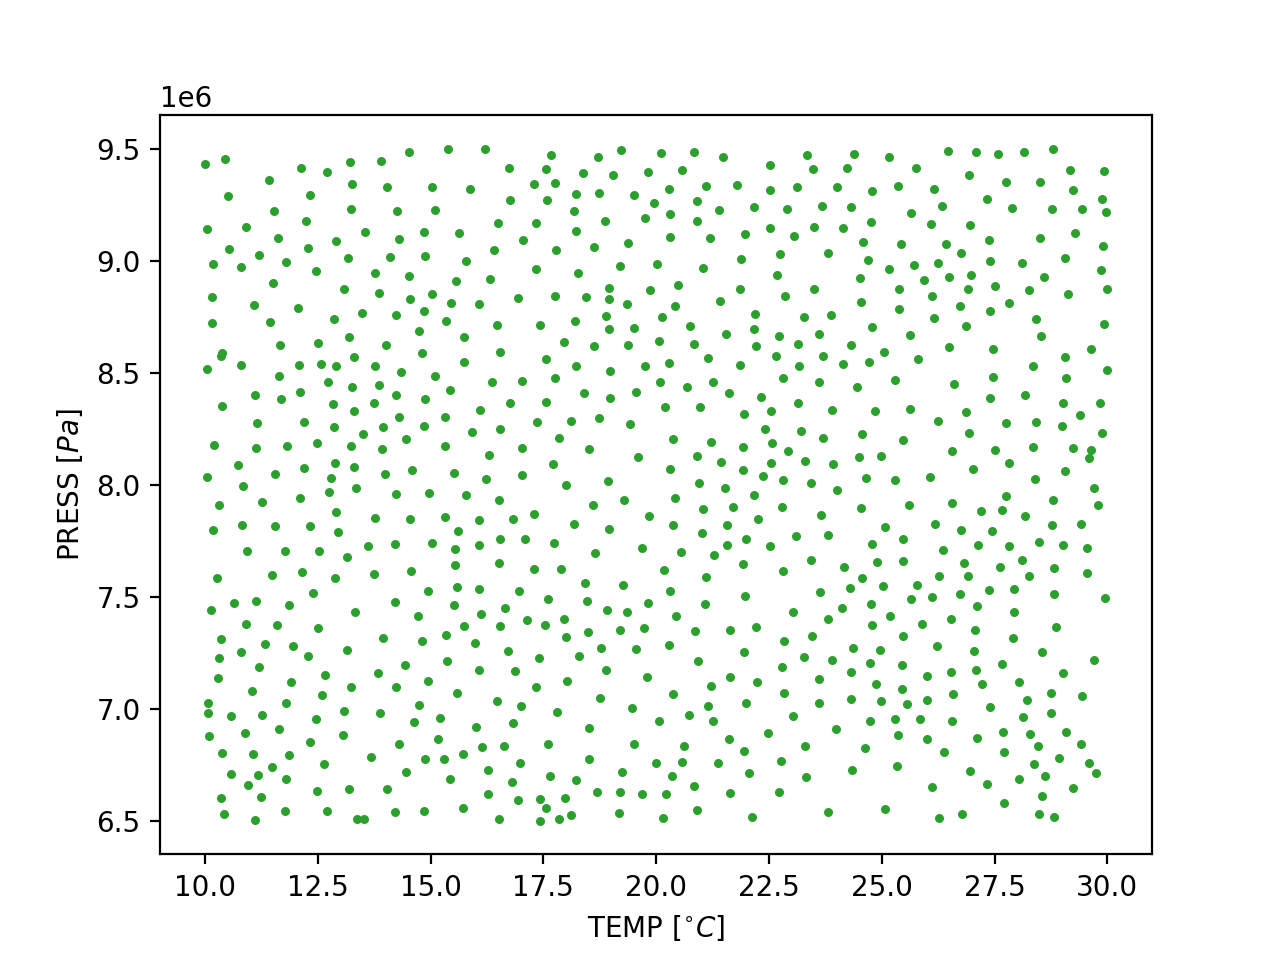
График распределения разреженного набора значений параметров давлений и температур.#
См. также
Подробное практическое руководство выполнения параметрических исследований приведено в соответствующем разделе документации REPEAT VISION.
На следующем шаге необходимо создать общую таблицу design_cases, пригодную для сохранения всех расчётных случаев, содержащих граничные условия по давлениям и температурам, имена которых содержатся в списке model_info.potentials, а также значения результатов расчёта потоков энергии и массовых расходов газа для узла №2, имена которых содержатся в списке node_2.flows.
result_names = [*model_info.potentials, *node_2.flows]
design_cases = input_data.copy(deep = True)
for param in result_names:
    design_cases[param] = pd.NA

design_cases.head()
Далее требуется выполнить цикл расчётов модели на платформе REPEAT VISION. Для этого создаётся и выполняется функция solve в следующей ячейке.
def solve(input_data, design_cases):
    for case_num, variables in input_data.iterrows():
        with model as md:
            md.run(variables)
            for param in result_names:
                design_cases.loc[case_num, param] = md.get_results(param).iloc[-1]

solve(input_data, design_cases)
На следующем шаге вычисляются значения массового расхода "flowrate_1" и потока энергии "energy_1", в соответствии с требованиями к модели машинного обучения с целью дальнейшей интеграции на платформу REPEAT VISION.
design_cases[node_1.flows] = - design_cases[node_2.flows]
Подсказка
В процессе вычисления значений массового расхода "flowrate_1" и потока энергии "energy_1" в ячейке выше используется объект node_1, хранящий имена расчётных значений в аттрибуте flows, сформированный ранее при описании узла №1 ML модели.
Далее необходимо сохранить таблицу расчётных случаев design_cases на случай создания других ML моделей с использованием уже полученных результатов моделирования.
design_cases.to_csv("gas_flow_data.csv")
5. Анализ результатов расчётов#
Для отображения результатов расчётов требуется создать вспомогательную функцию трёхмерной визуализации на основе возможностей пакета matplotlib.
def plot_3d_scatter(table, column = "flowrate_2", units = "$[kg/s]$", c = "tab:blue"):
    fig = plt.figure(dpi = 200)
    ax = fig.add_subplot(projection = "3d")
    ax.scatter(
        table["pressure_2"],
        table["temperature_2"],
        table[column],
        marker = ".",
        c = c
      )
    ax.view_init(azim = 240)
    ax.set_xlabel("pressure_2 $[Pa]$")
    ax.set_ylabel("temperature_2 $[^{\circ}C]$")
    ax.set_zlabel(f"{column} {units}")
    fig.savefig(f"results_{column}.png")
    plt.show()
Далее необходимо вызвать вспомогательную функцию для отображения трёхмерной зависимости выбранного потока от потенциалов. Сначала функции plot_3d_scatter передаётся только таблица расчётных случаев design_cases для отображения массового расхода flowrate_2 в зависимости от давления pressure_2 и температуры temperature_2 на выходе из штуцера.
plot_3d_scatter(design_cases)
На графике приведена зависимость массового расхода, в зависимости от давления и температуры на выходе из штуцера (блок №14 отверстие (П), узел №2 ML модели).
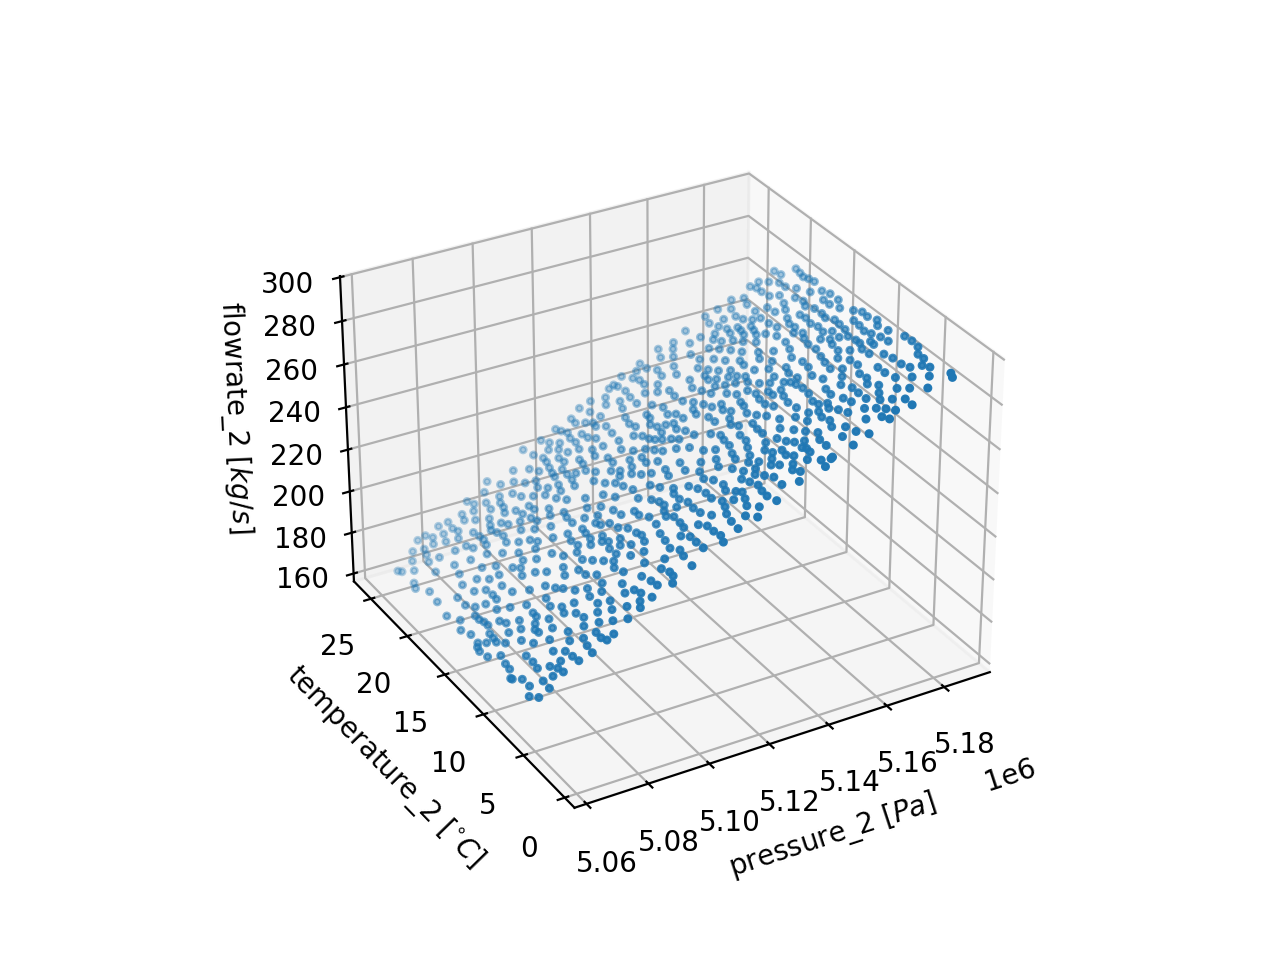
Результаты расчёта массового расхода в зависимости от давления и температуры на выходе из штуцера#
На следующем шаге вызывается вспомогательная функция plot_3d_scatter для отображения потока энергии energy_2.
plot_3d_scatter(design_cases, "energy_2", "$[W]$", "tab:orange")
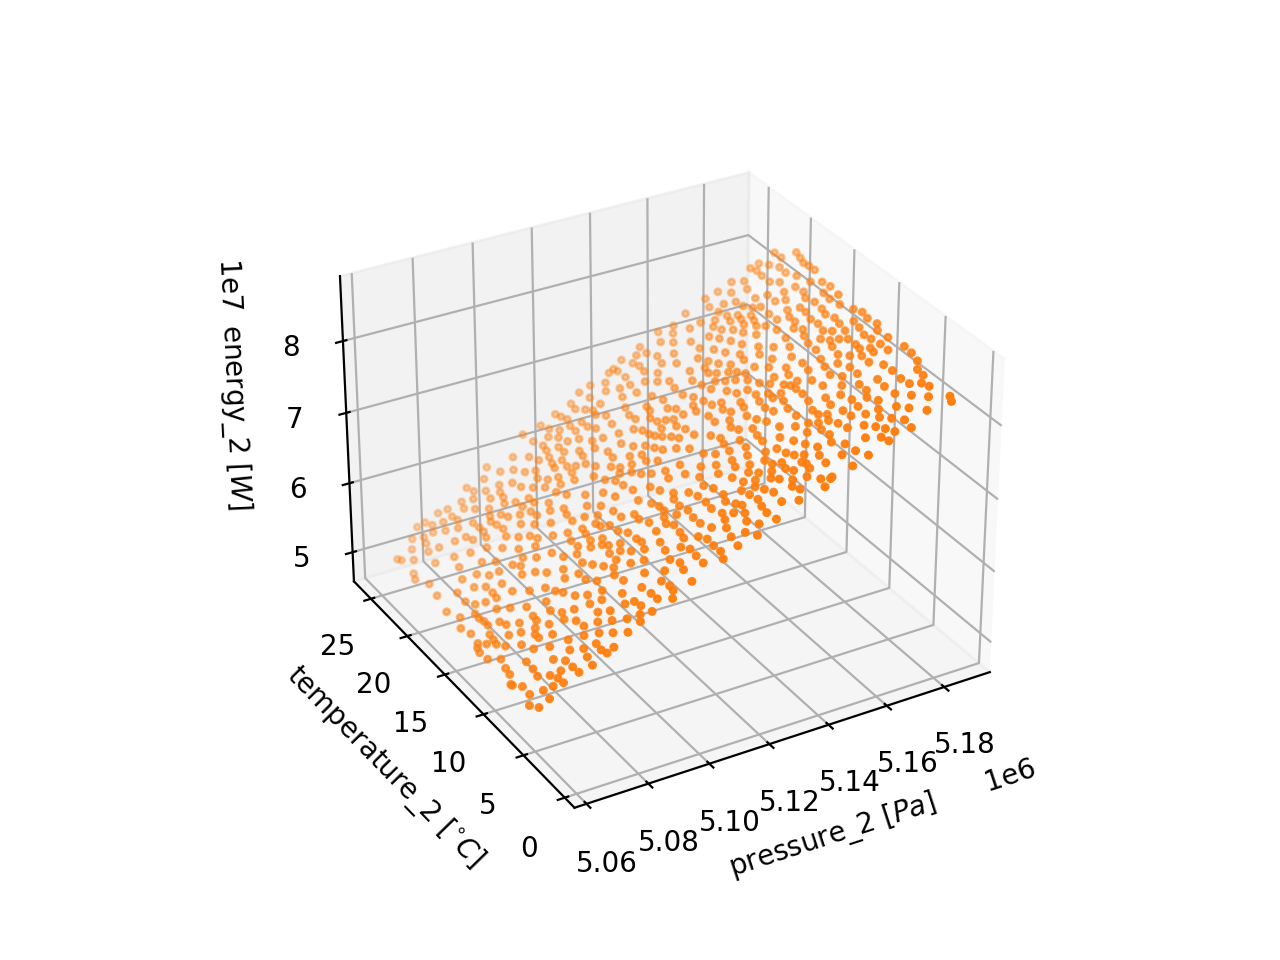
Результаты расчёта потока энергии в зависимости от давления и температуры на выходе из штуцера#
На графиках, приведённых выше, необходимо отметить различие порядков значений параметров модели (см. таблицу ниже).
Параметр модели |
Порядок |
|---|---|
Массовый расход газа |
2 |
Поток энергии |
7 |
Температура |
1 |
Давление |
6 |
Массовый расход газа, поток энергии и температура обладают нелинейной зависимостью от давления;
Параметры модели обладают значительно различающимися порядками величин.
Сделанные выводы оказывают непосредственное влияние на выбор архитектуры модели машинного обучения, которая будет создаваться в рамках следующего раздела.
6. Предварительная обработка данных#
В рамках данного раздела будут выполнены шаги подготовки расчётных данных к процессу обучения и проверки ML модели.
Сначала необходимо создать словарь dict для хранения следующих настроек.
Ключ |
Описание настройки |
|---|---|
|
Устройство, которое будет использовано для обучения модели на вашей локальной машине |
|
Тип используемых данных в тензорах |
TENSOR_SETTINGS = {
    "device" : "cuda" if torch.cuda.is_available() else "cpu",
    "dtype" :  torch.double,
}
В следующей ячейке необходимо подготовить несколько вспомогательных функций.
def to_tensor(data) -> torch.tensor:
    return torch.tensor(data, **TENSOR_SETTINGS)

def to_column_tensor(data):
    return to_tensor(data).reshape(-1, 1)
Далее необходимо создать вспомогательную функцию get_torch_tensors для подготовки структур данных torch.tensor из набора таблиц pandas.DataFrame.
def get_torch_tensors(tables : list[pd.DataFrame]):
    total = []
    for table in tables:
        tensors = {}
        for key, values in table.items():
            tensors[key] = to_column_tensor(values.to_numpy())

        total.append(tensors)

    return total
В следующей ячейке, используя функцию train_test_split библиотеки scikit-learn, выполняется разделение ранее подготовленных данных обучающую выборку и проверочную.
1potential_train, potential_test, flow_train, flow_test = train_test_split(
2  design_cases[model_info.potentials], design_cases[model_info.flows],
3  test_size = 0.33, random_state = 42
4)
На строке 2 ячейки кода, приведённой выше, используется следующие списки для удобства разделения данных:
Список потенциалов
model_info.potentials- давления и температуры в узлах модели,['pressure_1', 'temperature_1', 'pressure_2', 'temperature_2'];Список потоков
model_info.flows- массовые расходы и потоки энергии в узлах модели,['flowrate_1', 'energy_1', 'flowrate_2', 'energy_2'].
Данные списки были настроены ранее при подготовке описания ML модели.
На следующем шаге с помощью ранее созданной функции get_torch_tensors выполняется подготовка структур данных torch.tensor потенциалов модели для последующего обучения и проверки ML модели.
potential_train_tensor, potential_test_tensor = get_torch_tensors(
  (potential_train, potential_test)
  )
6.1. Стандартизация данных#
Теперь необходимо выполнить шаг, основанный на результатах ранее выполненного анализа данных, в котором выявлено значительное различие порядков величин параметров модели.
На обучающей выборке потенциалов модели создаётся экземпляр класса StandardScaler библиотеки scikit-learn, для последующего вычисления среднего значения потенциалов и их среднего квадратичного отклонения.
potential_scaler = StandardScaler()
potential_scaler.fit(potential_train)
Важно
Стандартизация позволяет линейно преобразовать данные к нулевому среднему значению и единичному СКО с целью дальнейшего обеспечения сходимости решения оптимизатора при минимизации невязки, вычисляемой функцией потерь, в процессе обучения ML модели.
На следующем шаге необходимо выполнить стандартизацию потоков модели.
1flow_scaler = StandardScaler()
2flow_scaler.fit(flow_train)
3flow_train_scaled = to_tensor(flow_scaler.transform(flow_train))
4flow_test_scaled = to_tensor(flow_scaler.transform(flow_test))
На строках 3 и 4 ячейки кода, приведённой выше, выполняется стандартизация обучающей и проверочной выборок потоков модели, а также их преобразование в структур данных torch.tensor с помощью ранее созданной функции to_tensor.
Далее необходимо подготовить средние значения и СКО потенциалов и потоков модели.
summary = dict(
    potential_mean = to_tensor(potential_scaler.mean_),
    potential_scale = to_tensor(potential_scaler.scale_),
    flow_mean = to_tensor(flow_scaler.mean_),
    flow_scale = to_tensor(flow_scaler.scale_),
)
Рассчитанные выше СКО и средние значения параметров модели будут использованы далее при описании архитектуры модели машинного обучения.
7. Создание модели машинного обучения течения газа через штуцер#
На следующем шаге выполняется создание модели машинного обучения с применением фреймворка PyTorch. Для аппроксимации процесса течения газа через штуцер необходимо создать модель многослойной нейронной сети, которая выбрана ввиду нелинейности зависимостей потоков от потенциалов, выявленных в результате анализа полученных данных.
7.1. Создание метода инициализации#
Описание ML модели необходимо начать с метода инициализации класса ModelOrifice, наследующего базовый класс nn.Module нейронной сети фреймворка PyTorch.
 1class ModelOrifice(nn.Module):
 2    def __init__(self, potential_mean, potential_scale, flow_mean, flow_scale,
 3                 hidden_size = 128):
 4        super().__init__()
 5        self.common_part = nn.Sequential(
 6            nn.Linear(4, hidden_size),
 7            nn.LayerNorm(hidden_size),
 8            nn.Tanh(),
 9            nn.Linear(hidden_size, hidden_size),
10            nn.LayerNorm(hidden_size),
11            nn.Tanh()
12        )
13        self.flowrate_part = nn.Linear(hidden_size, 1, bias = False)
14        self.energy_part = nn.Linear(hidden_size, 1, bias = False)
15        self.potential_mean = potential_mean
16        self.potential_scale = potential_scale
17        self.flow_mean = flow_mean
18        self.flow_scale = flow_scale
Строки 2-3. Для инициализации экземпляра класса нейронной сети
ModelOrificeнеобходимо передать в качестве аргументов созданные ранее средние значения и СКО потенциалов и потоков модели. Также при инициализации требуется передать аргументуhidden_sizeколичество нейронов скрытых слоёв.Строка 5. В аттрибуте ML модели
common_partсоздаётся последовательность из двух слоёв нейронов с помощью класса nn.Sequential. Последовательность предназначена для выполнения общих преобразований данных входных параметров модели.Строка 6. В общем компоненте ML модели
common_partпервым создаётся класс линейных преобразованийnn.Linear, принимающий 4 параметра (давления и температуры в двух узлах модели) и вычисляющий промежуточный результат для нейронов следующего слоя, количество которых настраивается с помощью аргументаhidden_size.Строки 7-8. Далее в общем компоненте
common_partсоздаётся классnn.LayerNormдля выполнения нормализации значений параметров в первом слое нейронов. Также создаётся классnn.Tanhдля активации нейронов следующего слоя по функции гиперболического тангенса.Строки 9-11. В общем компоненте
common_partсоздаётся второй слой нейронов, аналогичный первому слою.Строки 13-14. Создаются отдельные компоненты
nn.LinearML модели, коэффициенты которых настраиваются отдельно для аппроксимации массового расхода газа в методеflowrate_part, а также для расчёта потока энергии газа в методеenergy_part. Методыflowrate_partиenergy_partучитывают значительное различие порядков величин между данными массовых расходов газа и данными потоков энергии.Строки 15-18. Создаются аттрибуты средних значений и СКО потенциалов и потоков модели.
7.2. Создание метода forward#
На данном этапе создаётся метод forward, определяющий порядок прохождения входных данных через сеть.
20    def forward(self, pressure_1, temperature_1, pressure_2, temperature_2):
21        x = torch.cat([pressure_1, temperature_1, pressure_2, temperature_2],
22                      dim = 1)
23        x_scaled = (x - self.potential_mean) / self.potential_scale
24        common_results = self.common_part(x_scaled)
25        flowrate_2 = self.flowrate_part(common_results)
26        energy_2 = self.energy_part(common_results)
27        flowrate_1 = - flowrate_2
28        energy_1 = - energy_2
29        flows = torch.cat([flowrate_1, energy_1, flowrate_2, energy_2],
30                          dim = 1)
31        if self.training:
32            return flows
33
34        return self.postprocessing(flows)
Строка 20. Создаётся метод
forwardклассаModelOrifice, входными аргументами которого являются структурыtorch.tensor, содержащие данные давлений и температур для двух узлов модели.Строки 21-22. Выполняется подготовка исходных параметров. Давления и температуры двух узлов модели объединяются в общий тензор для передачи в первый слой модели. Объединение параметров выполняется по столбцам
dim = 1.Строка 23. Выполняется стандартизация потенциалов ML модели для устранения различий в порядках значений потенциалов модели.
Строка 24. Выполняется промежуточный расчёт потоков общем компоненте
common_partML модели.Строки 25-26. Выполняется расчёт массового расхода газа и потока энергии в методах
flowrate_partиenergy_partсоответственно для узла №2 ML модели.Строки 27-28. Вычисляются потоки для узла №1 ML модели в соответствии с ранее выполненным формулированием задачи.
Строки 29-30. Выполняется подготовка потоков для двух узлов модели. Объединение параметров выполняется по столбцам
dim = 1. Потоки объединяются в общий тензор для последующей передачи в функцию потерь или в функцию обработки результатов расчётов в зависимости от состояния модели: состояние обучения или вычисления.Строки 31-34. В случае обучения модели значение
self.trainingравноTrueи расчётные значения потоков передаются в функцию потерь. В ином случае выполняется обработка результатов расчёта потоков модели (описание данного процесса в следующем разделе).
7.3. Создание метода обработки результатов расчёта#
На заключительном этапе описания класса нейронной сети необходимо описать методы обработки результатов расчёта массового расхода газа и потока энергии для двух узлов модели. Обработка результатов расчёта потоков необходима во время непосредственной эксплуатации ML модели (Machine learning Inference) после выполнения процесса обучения ML модели.
В процессе обработки результатов расчёта выполняется преобразование стандартизованных величин потоков модели к исходному масштабу массового расхода газа и потока энергии.
36    def postprocessing(self, flows):
37        orig_flows = flows * self.flow_scale + self.flow_mean
38        columns = range(flows.shape[1])
39
40        return [self.get_column_vector(orig_flows, i) for i in columns]
41
42    def get_column_vector(self, tensor, column):
43        return tensor[:, column].reshape(-1, 1)
Строка 36. Создаётся метод
postprocessingклассаModelOrifice, принимающий в качестве аргумента тензорflows, содержащий массовые расходы газа и потоки энергии для двух узлов модели.Строка 37. Преобразуются к исходному масштабу массовые расходы газа и потоки энергии.
Строка 40. В соответствии с требованиями к структурам данных со стороны нейтрального формата ONNX и платформы REPEAT VISION тензор потоков преобразуется методом
get_column_vectorв список вектор-столбцов для каждого узла модели, который должен содержать массовый расход и поток энергии газа.
7.4. Весь код модели#
Для удобства использования ниже приводится весь код класса многослойной нейронной сети, предназначенной для аппроксимации процесса течения газа через штуцер.
 1class ModelOrifice(nn.Module):
 2    def __init__(self, potential_mean, potential_scale, flow_mean, flow_scale,
 3                 hidden_size = 128):
 4        super().__init__()
 5        self.common_part = nn.Sequential(
 6            nn.Linear(4, hidden_size),
 7            nn.LayerNorm(hidden_size),
 8            nn.Tanh(),
 9            nn.Linear(hidden_size, hidden_size),
10            nn.LayerNorm(hidden_size),
11            nn.Tanh()
12        )
13        self.flowrate_part = nn.Linear(hidden_size, 1, bias = False)
14        self.energy_part = nn.Linear(hidden_size, 1, bias = False)
15        self.potential_mean = potential_mean
16        self.potential_scale = potential_scale
17        self.flow_mean = flow_mean
18        self.flow_scale = flow_scale
19
20    def forward(self, pressure_1, temperature_1, pressure_2, temperature_2):
21        x = torch.cat([pressure_1, temperature_1, pressure_2, temperature_2],
22                      dim = 1)
23        x_scaled = (x - self.potential_mean) / self.potential_scale
24        common_results = self.common_part(x_scaled)
25        flowrate_2 = self.flowrate_part(common_results)
26        energy_2 = self.energy_part(common_results)
27        flowrate_1 = - flowrate_2
28        energy_1 = - energy_2
29        flows = torch.cat([flowrate_1, energy_1, flowrate_2, energy_2],
30                          dim = 1)
31        if self.training:
32            return flows
33
34        return self.postprocessing(flows)
35
36    def postprocessing(self, flows):
37        orig_flows = flows * self.flow_scale + self.flow_mean
38        columns = range(flows.shape[1])
39
40        return [self.get_column_vector(orig_flows, i) for i in columns]
41
42    def get_column_vector(self, tensor, column):
43        return tensor[:, column].reshape(-1, 1)
7.5. Описание процесса обучения ML модели#
После создания класса ModelOrifice, описывающего модель нейронной сети, необходимо настроить оптимизатор, который предназначен для определения неизвестных весов ML модели в процессе минимизации функции потерь.
1torch.manual_seed(42)
2model = ModelOrifice(hidden_size = 180, **summary).double().to(TENSOR_SETTINGS["device"])
3criterion = nn.MSELoss()
4optimizer = optim.AdamW(model.parameters(), lr = 1e-3, weight_decay = 1e-3)
5scheduler = ReduceLROnPlateau(optimizer, "min", factor = 0.5, patience = 50)
6num_epochs = 3000
7train_losses, test_losses = [], []
Строка 2. Инициализация экземпляра класса модели
ModelOrificeс переводом модели в режим двойной точности методом.double()в соответствии с требованиями платформы REPEAT VISION к ML модели. Дополнительно ML модели передаётся настройка об используемом устройствеTENSOR_SETTINGS["device"]для выполнения процесса машинного обучения.Строка 3. Инициализация функции потерь
criterion, использующей среднеквадратичную ошибку в качестве критерия качества ML модели.Строка 4. Инициализация оптимизатора
AdamW. Эмпирически определяется значение настройкиlr = 1e-3(learning rate) иweight_decay = 1e-3.Строка 5. Инициализация экземпляра класса планировщика
ReduceLROnPlateau. Планировщик предназначен для уменьшения значения скорости обучения (learning rate), когда прекращается уменьшение среднеквадратичной ошибки.Строки 6-7. Создаётся переменная
num_epochs = 3000, определяющая количество эпох обучения ML модели. Так же создаются списки для сохранения значений функции потерь для обучающего и проверочного наборов данных с целью дальнейшего анализа процесса сходимости значения критерия качества ML модели.
После настройки оптимизатора далее выполняется описание цикла обучения ML модели.
 1for epoch in range(num_epochs):
 2    model.train()
 3    optimizer.zero_grad()
 4    outputs_train = model(**potential_train_tensor)
 5    loss_train = criterion(outputs_train, flow_train_scaled)
 6    loss_train.backward()
 7    optimizer.step()
 8    model.eval()
 9    with torch.no_grad():
10        model.train()
11        outputs_test = model(**potential_test_tensor)
12        model.eval()
13        loss_test = criterion(outputs_test, flow_test_scaled)
14
15    scheduler.step(loss_test)
16    train_losses.append(loss_train.item())
17    test_losses.append(loss_test.item())
Строки 2-7. Выполняется типовая часть определения весов ML модели на обучающей выборке данных, подробное описание которого приведено в уроке Аппроксимация решения дифференциального уравнения колебаний с помощью PINN.
Строки 8-15. В режиме вычисления модели вычисляется невязка на проверочном наборе данных
potential_test_tensorдля последующей передачи значенийloss_testв планировщикscheduler.Строки 16-17. Выполняется сохранения значений критериев качества ML модели, вычисленных на обучающем и проверочном наборах данных.
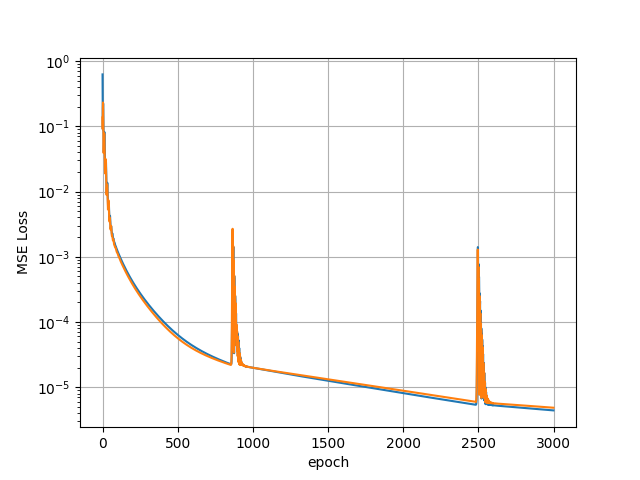
Значения среднеквадратичных ошибок в зависимости от эпохи обучения модели для обучающего и проверочного наборов данных#
На графиках выше приняты следующие обозначения.
Линии |
Описание |
|---|---|
Синяя линия |
Зависимость среднеквадратичной ошибки от номера итерации на обучающем наборе данных |
Оранжевая линия |
Зависимость среднеквадратичной ошибки от номера итерации на проверочном наборе данных |
7.6. Сохранение ML модели в файл ONNX#
В завершении процесса создания ML модели выполняется сохранение модели машинного обучения в нейтральный формат ONNX, используемый платформой REPEAT VISION для интеграции аппроксимационных моделей с целью их применения в структурном моделировании.
 1onnx_file = "model_orifice.onnx"
 2model.eval()
 3torch.onnx.export(
 4    model,
 5    args = (to_column_tensor(6456249.5),
 6            to_column_tensor(19.912780),
 7            to_column_tensor(5065394.0),
 8            to_column_tensor(16.410051),
 9            ),
10    f = onnx_file,
11    opset_version = 17,
12    input_names = model_info.potentials,
13    output_names = model_info.flows,
14    )
Строка 1. Создаётся строковая переменная
onnx_file, содержащая имя сохраняемого файла формата ONNX, в который будет записана модель машинного обучения.Строка 2. ML модель переводится в режим вычисления с целью расчёта параметров массового расхода газа и потока энергии в исходном масштабе.
Строка 4. Функции
torch.onnx.export()первым аргументом передаётся ранее обученная модельmodel.Строки 5-9. Именованному аргументу
argsпередаются значения граничных условий давлений и температур, используемых по-умолчанию. В качестве структуры данных используетсяtorch.tensorразмерностью 1x1 с типомtorch.doubleв соответствии с требованиями платформы REPEAT VISION к ML модели. В качестве значений по-умолчанию используется один из проверочных расчётных случаев из ранее полученного набора данных.Строки 10. Именованному аргументу
fпередаётся имя сохраняемого файла формата ONNX из созданной ранее переменнойonnx_fileдля последующего использования на платформе REPEAT VISION.Строки 12. Именованному аргументу
input_namesприсваивается список имён граничных условий давлений и температур. Используется списокpotentialsиз объектаmodel_infoранее подготовленного описания ML модели.Строки 13. Именованному аргументу
output_namesпередаётся список имён результатов расчёта массовых расходов и потоков энергии для двух узлов ML модели. Используется списокflowsиз объектаmodel_infoранее подготовленного описания.
Далее выполняется запись необходимой информации о ML модели в нейтральный файл ONNX в соответствии с требованиями платформы REPEAT VISION к дополнительному описанию модели.
1properties = onnx.StringStringEntryProto()
2properties.key = "repeat_contract"
3properties.value = model_info.to_onnx()
4model_onnx = onnx.load(onnx_file)
5model_onnx.metadata_props.append(properties)
6onnx.save(model_onnx, onnx_file)
Строка 1. Создаётся структура данных
propertiesс помощью пакета onnx.Строка 2. Аттрибуту
keyпередаётся строковое значение ключа"repeat_contract", по которому блок Аппроксимационная модель (П) выполнит поиск необходимых настроек.Строка 3. Аттрибуту
valueпередаётся подготовленное ранее дополнительное описание ML модели путём вызова методаto_onnx()объектаmodel_info. Описание модели позволит блоку Аппроксимационная модель (П) обеспечить передачу давлений и температур в узлы ML модели, а в результате расчёта получить массовый расход и поток энергии.Строки 4-6. Выполняется чтение файла формата ONNX с ранее сохранённой ML моделью и добавление в структуру
metadata_propsобъектаproperties. В завершении выполняется перезапись ONNX файла ML моделью, содержащей дополнительное описание.
8. Интеграция ML модели на платформу REPEAT VISION#
В завершении работы требуется загрузить файл ML модели model_orifice.onnx на платформу REPEAT VISION с помощью блока Аппроксимационная модель (П) в ранее используемый проект.
Необходимо скопировать и вставить ранее созданные блоки резервуаров (П) №2 и №5, а также участки трубопроводов (П) №1 и №3. Также необходимо добавить блок Датчик расхода (П) №29, который должен выводить значение массового расхода \([кг/c]\), измеренного на участке трубопровода (П) №25, в блок выходной порт №30. После выполненных действий трубопроводная система с блоком Аппроксимационная модель (П) должна соответствовать схеме, приведённой ниже.
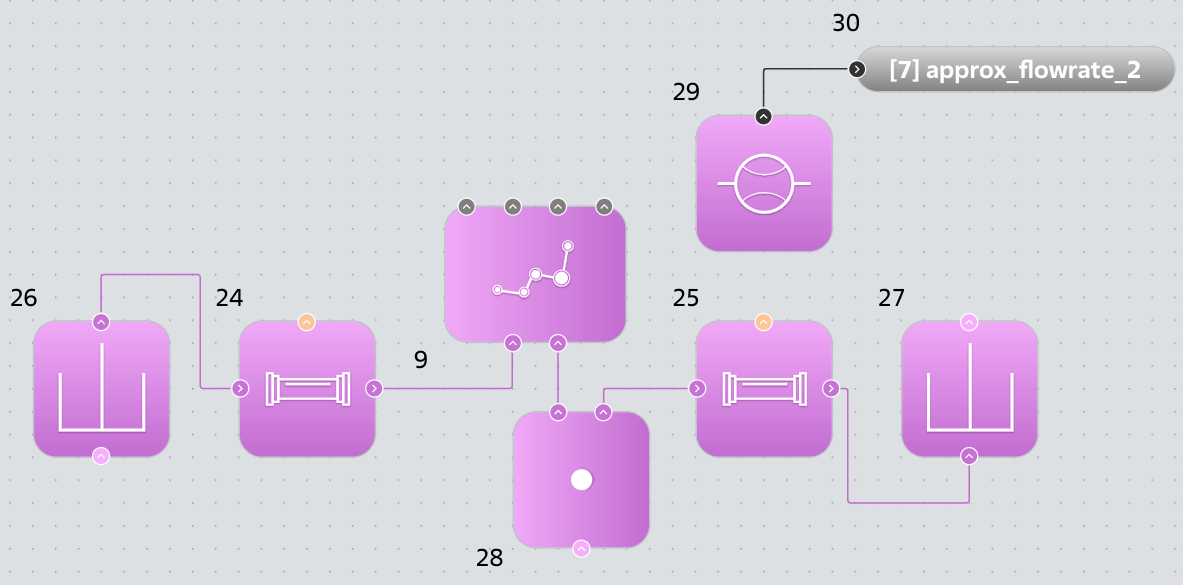
Трубопроводная система с блоком, аппроксимирующем процесс течения газа через штуцер.#
Весь, проект, содержащий трубопроводную систему для моделирования течения газа через штуцер, а также систему с блоком Аппроксимационная модель (П), изображён на схеме, приведённой ниже.
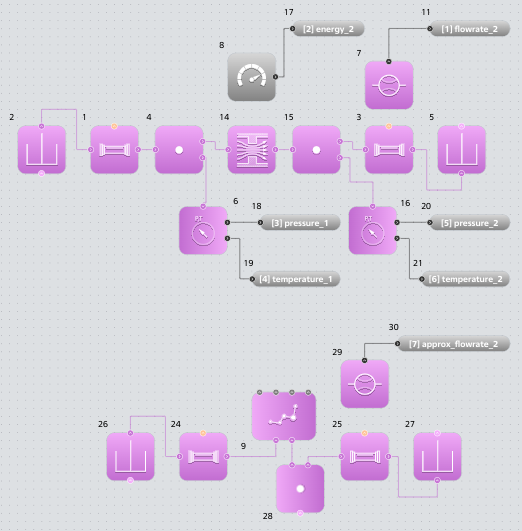
Проект трубопроводных систем#
Необходимо сохранить данный проект с новым названием и выполнить независимое тестирование ML модели, аппроксимирующей процесс течения газа через штуцер.
9. Тестирование модели машинного обучения#
Примечание
Вы можете скачать файл Jupyter ноутбука если хотите быстро выполнить этап тестирования модели машинного обучения.
Для независимой количественной оценки качества ML модели выполняется тестирование аппроксимационной модели на платформе REPEAT VISION с использованием эталонных результатов расчёта массового расхода газа в трубопроводной системе, созданной ранее.
Процесс тестирования предлагается выполнить с помощью Python, используя ранее созданный скрипт для параметрических исследований. Его копирование и изменение приводит к программе тестирования, представленной далее.
В первой ячейке необходимо выполнить типовые действия по импорту необходимых модулей, а также необходимо создать объекты для взаимодействия с платформой REPEAT VISION.
import matplotlib.pyplot as plt
import numpy as np
import pandas as pd
import repeat as rp
import repeat.parametric_study as ps


user = rp.User(
    "enter a unique API key from REPEAT VISION user cabinet instead of this comment"
)
app = rp.Application(user)
# enter a project ID from REPEAT VISION application instead of 12345
project = 12345
app = rp.Application(user)
t_interval = rp.TimeInterval(start = 900, end = 1000)
model = app.get_exploration_model(project, t_interval)
print(model, model.existing_variables, sep = "\n")
Далее требуется создать множество значений параметров давлений и температур с помощью функции get_cartesian_product.
variable_values = dict(
    PRESS = np.linspace(6.75e6, 9.42e6, num = 21),
    TEMP = np.array([20.]),
)
input_data = ps.get_cartesian_product(model, variable_values)
Также необходимо создать общую таблицу design_cases, пригодную для сохранения всех расчётных случаев, содержащих граничные условия по температурам и давлениям, а также значения результатов расчёта массовых расходов:
"flowrate_2"- эталонные значения массового расхода в трубопроводной системе для моделирования течения газа через штуцер;"approx_flowrate_2"- значения массового расхода, полученные в трубопроводной системе с блоком, аппроксимирующем процесс течения газа через штуцер.
result_names = ["flowrate_2", "approx_flowrate_2"]
design_cases = input_data.copy(deep = True)
for param in result_names:
    design_cases[param] = pd.NA

design_cases.head()
На следующем шаге создаётся и выполняется функция solve, которая применялась ранее при параметрических исследованиях.
def solve(input_data, design_cases):
    for case_num, variables in input_data.iterrows():
        with model as md:
            md.run(variables)
            for param in result_names:
                design_cases.loc[case_num, param] = md.get_results(param).iloc[-1]

solve(input_data, design_cases)
Далее на полученных результатах независимых расчётов вычисляется относительное отклонение аппроксимированных значений flow_approx от эталонных значений массового расхода flow_exact с помощью функции calc_relative_error.
def calc_relative_error(flow_exact, flow_approx):
    return (flow_exact - flow_approx).abs() / flow_exact * 100

design_cases["error"] = calc_relative_error(
    flow_exact = design_cases["flowrate_2"],
    flow_approx = design_cases["approx_flowrate_2"]
    )
На следующем шаге создаётся график для сравнительного анализа результатов расчёта ML модели и эталонных результатов массового расхода.
ax = design_cases.plot(x = "PRESS", y = "flowrate_2", c = "tab:blue")
design_cases.plot.scatter(x = "PRESS", y = "approx_flowrate_2", c = "tab:red", ax = ax)
ax.set_xlabel("pressure $[Pa]$")
ax.set_ylabel("flowrate $[kg/s]$")
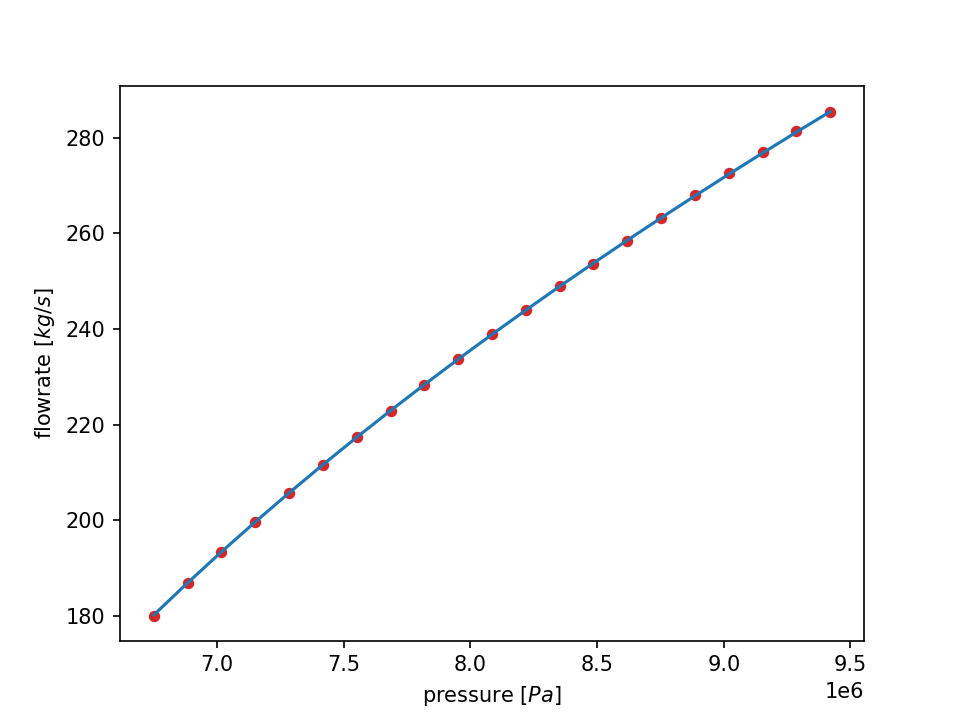
График зависимости массового расхода от давления в резервуаре.#
На графике выше приняты следующие обозначения.
Линии |
Описание |
|---|---|
Синяя линия |
Зависимость массового расхода от давления в резервуаре трубопроводной системы для моделирования течения газа через штуцер |
Красные точки |
Зависимость аппроксимированных значений массового расхода от давления в резервуаре трубопроводной системы с интегрированной моделью машинного обучения |
print(f'{design_cases["error"].max() :.3f} %')
Максимальное относительное отклонение аппроксимированных значений от эталонных значений массового расхода составляет 0.095 %. Данный результат показывает применимость алгоритмов нейронных сетей для аппроксимации моделей течения газа в системном моделировании на платформе REPEAT VISION.
10. Выводы#
В результате выполнения данного практического руководства:
Вы познакомились с процессом подготовки модели машинного обучения для аппроксимации процесса течения газа через штуцер с помощью платформы REPEAT VISION и PyTorch;
Вы узнали, как интегрировать на платформу REPEAT VISION ML модель с помощью блока Аппроксимационная модель (П) для решения задач моделирования течения газа в трубопроводных системах;
Вы познакомились с возможностями Python пакета repeat_onnx который обеспечил интеграцию ML модели на платформу REPEAT VISION, упростил процесс подготовки данных и процесс создания ML модели;
Вы познакомились с тестированием модели машинного обучения как в процессе её создания, так и в процессе её эксплуатации на платформе REPEAT VISION.