

Простая модель машинного обучения теплопроводности#
В практическом руководстве представлены шаги реализации простой модели машинного обучения, предназначенной для аппроксимации стационарного процесса переноса тепла теплопроводностью в стенке детали изделия, а также представлен способ применения ML модели на платформе REPEAT VISION.
Примечание
Если вы не обладаете базовыми навыками использования библиотеки Теплообмен платформы REPEAT VISION, то ознакомьтесь с вводным уроком перед тем, как продолжить выполнение данного практического руководства.
1. Постановка задачи переноса тепла теплопроводностью в стенке детали изделия#
Для того, чтобы сфокусироваться на процессе создания модели машинного обучения, необходимо подготовить несложную задачу расчёта теплового потока в стенке детали изделия, обладающей заданной теплопроводностью. Задача будет основана на вводном уроке библиотеки Теплообмен платформы REPEAT VISION.
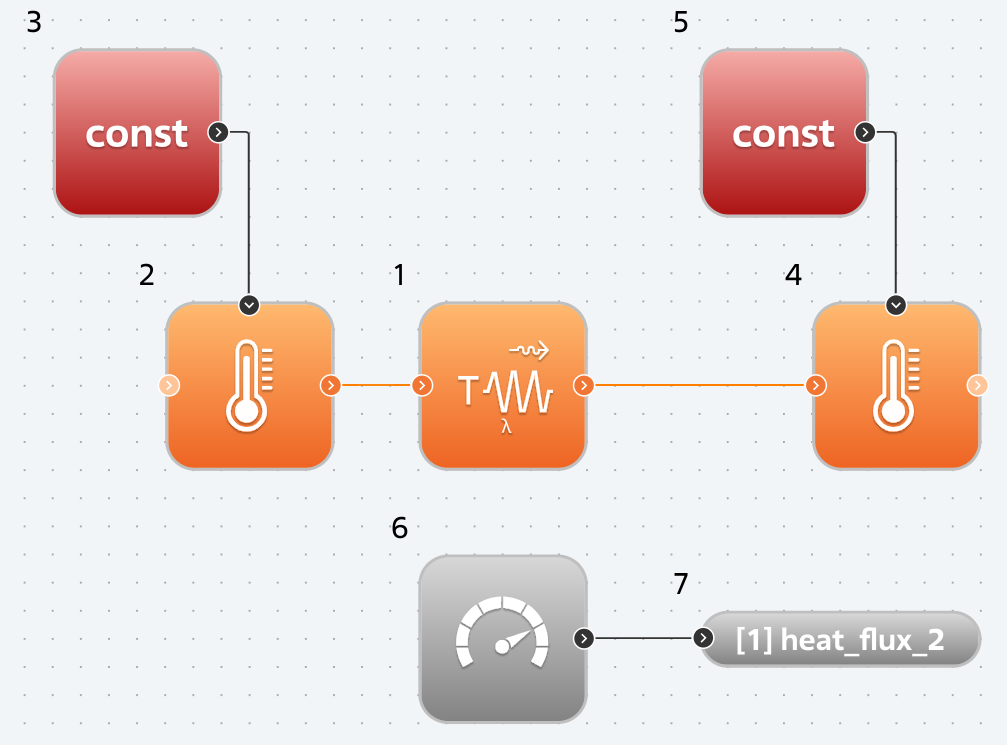
Схема проекта с названием, например Теплопроводность в стенке, для расчёта теплового потока в стенке детали изделия представлена на рисунке ниже и описывается уравнением блока №1 Теплопроводность.
Модель расчёта теплового потока в стенке детали изделия.#
Изображённый выше проект позволяет исследовать изменение теплового потока, являющегося результатом выполнения расчёта, при изменении параметров, приведённых в таблице ниже.
Параметр |
Тип параметра |
Имя глобальной переменной |
Применяется к блоку |
|---|---|---|---|
Внутренняя температура стенки |
Граничное условие \([^{\circ}C]\) |
TEMPERATURE_1 |
блок №3 |
Внешняя температура стенки |
Граничное условие \([^{\circ}C]\) |
TEMPERATURE_2 |
блок №5 |
блок №1 Теплопроводность обладает следующими настройками:
Свойство |
Значение |
|---|---|
Геометрия стенки |
Плоская |
Площадь поверхности \([м^2]\) |
3 |
Толщина стенки, \([м]\) |
0.005 |
Тип теплопроводности |
Постоянная |
Теплопроводность, \([Вт/м^{\circ}C]\) |
1.4 |
Результат расчёта теплового потока \([Вт]\) передаётся из блока №6 Датчик в блок №7 Выходной порт с пользовательским названием heat_flux_2.
Для данной стационарной постановки задачи достаточно будет использовать следующие настройки проекта:
Время моделирования \([с]\) |
Шаг интегрирования \([мс]\) |
Шаг дискретизации \([мc]\) |
|---|---|---|
0.1 |
50 |
50 |
1.1. Требование к формулированию задачи для подготовки модели машинного обучения#
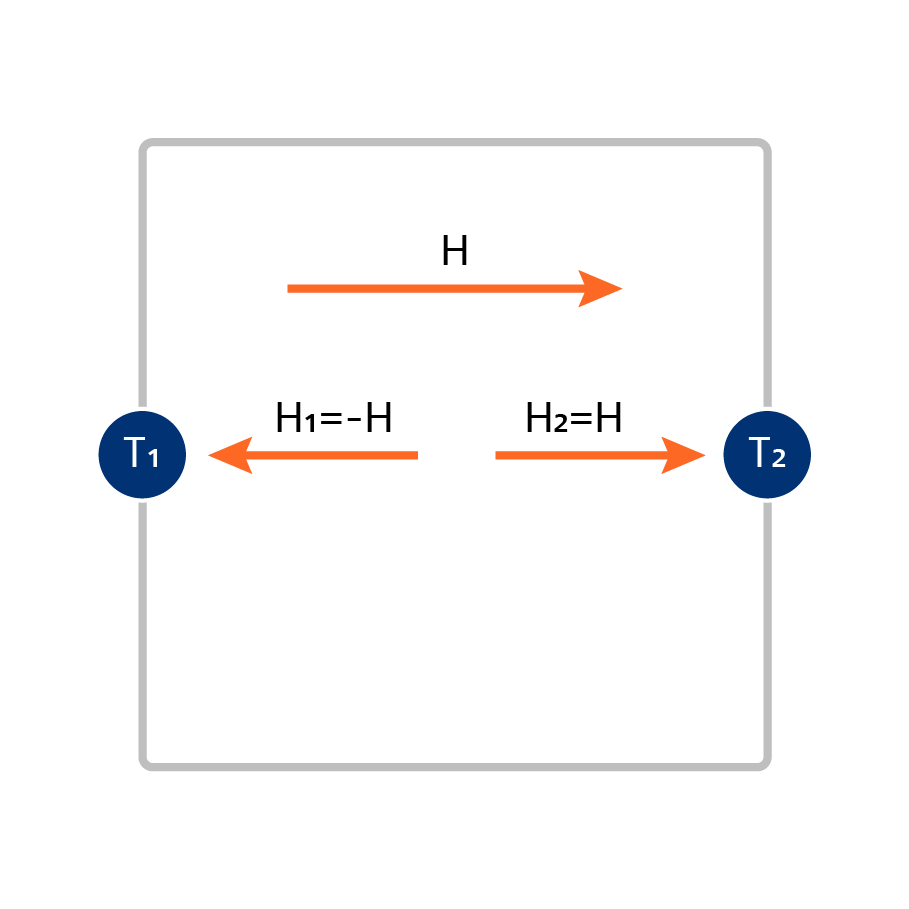
Принимая во внимание требования к модели машинного обучения с целью дальнейшей интеграции на платформу REPEAT VISION для взаимодействия с блоками библиотеки Теплообмен далее описывается случай формулирования задачи, в которой тепловой поток heat_flux_2 положительно направлен от блока №2 с граничным условием температуры TEMPERATURE_1 к блоку №4 с граничным условием температуры TEMPERATURE_2. Данный случай отдельно описан в справке блока Аппроксимационная модель (Теплообмен) и выглядит следующим образом.
Расчёт теплового потока от узла 1 к узлу 2 аппроксимационной модели с двумя узлами.#
На схеме выше приняты следующие обозначения.
Обозначения |
Описание |
|---|---|
T1 |
Узел модели с граничным условием температуры |
T2 |
Узел модели с граничным условием температуры |
H → |
Положительное направление теплового потока модели heat_flux_2 |
При подготовке данных расчёта тепловых потоков в рамках параметрических исследований необходимо создать дополнительный поток heat_flux_1, равный отрицательному значению heat_flux_2 в соответствии со схемой, приведённой выше.
2. Подготовка к работе#
Примечание
Вы можете скачать файл Jupyter ноутбука, а также данные данные для обучения ML модели, если хотите быстро выполнить данный урок на вашем персональном компьютере.
Также вы можете скачать файл ML модели и сразу использовать её в проекте на платформе REPEAT VISION с помощью блока Аппроксимационная модель (Теплообмен).
Вся последующая работа подготовки данных и создания ML модели должна выполняться на локальной машине ввиду использования PyTorch для машинного обучения. Работу предлагается выполнять в Jupyter.
Перед началом работы необходимо установить Python пакет repeat, необходимый для взаимодействия с платформой REPEAT VISION, а также установить пакеты для работы с данными и создания ML модели.
Необходимо выполнить в командной строке вашего компьютера следующие команды и продолжить работу в Jupyter ноутбуке.
mkdir ml_heat_transfer
cd ml_heat_transfer
python -m venv repeat_ml.
source repeat_ml/bin/activate
python -m pip install repeat torch scikit-learn pandas onnx matplotlib tqdm jupyterlab ipywidgets

jupyter lab
mkdir ml_heat_transfer
cd ml_heat_transfer
python -m venv repeat_ml.
repeat_ml\Scripts\Activate.ps1
python -m pip install repeat torch scikit-learn pandas onnx matplotlib tqdm jupyterlab ipywidgets

jupyter lab
См. также
Более подробную информацию о работе с Python на локальной машине для взаимодействия с платформой REPEAT VISION вы можете найти в наших уроках:
В первой ячейке вашего ноутбука выполните импорт Python пакетов, необходимых для подготовки данных и обработки результатов расчётов, а также Python пакет repeat с модулем параметрических исследований.
import numpy as np
import pandas as pd
import torch
import torch.nn as nn
import torch.optim as optim
from sklearn.model_selection import train_test_split
from tqdm.notebook import tqdm
import matplotlib.pyplot as plt
import repeat as rp
import repeat.parametric_study as ps
3. Подготовка данных#
Для последующего создания модели машинного обучения необходимо подготовить набор данных, включающий:
Температурные граничные условия ранее созданной модели теплопроводности;
Результаты расчёта тепловых потоков для каждого расчётного случая.
Для подготовки необходимого набора данных потребуются алгоритмы выполнения параметрических исследований модели расчёта тепловых потоков в стенке детали изделия.
См. также
Подробное практическое руководство выполнения параметрических исследований приведено в соответствующем разделе документации REPEAT VISION.
Далее кратко описаны основные шаги расчёта набора тепловых потоков в стенке детали изделия на сетке параметров температур модели.
Сначала требуется настроить подключение к платформе REPEAT VISION и выбрать модель для выполнения параметрических исследований.
user = rp.User(
  "enter a unique API key from REPEAT VISION user cabinet instead of this comment"
  )
app = rp.Application(user)
# enter a project ID from REPEAT VISION application instead of 12345
project = 12345
t_interval = rp.TimeInterval(start = 50, end = 100)
model = app.get_exploration_model(project, t_interval)
print(model, model.existing_variables, sep = "\n")
Для алгоритма подготовки сетки значений параметров температур в следующей ячейке создайте словарь variable_values и с помощью функции get_cartesian_product создайте декартово произведение множества значений параметров температур.
variable_values = dict(
    TEMPERATURE_1 = np.linspace(5, 25, num = 11),
    TEMPERATURE_2 = np.linspace(-15, 35, num = 11),
)
input_data = ps.get_cartesian_product(model, variable_values)
axis = input_data.plot.scatter(x = 'TEMPERATURE_1', y = 'TEMPERATURE_2', c = 'tab:red')
axis.set_xlabel("TEMPERATURE_1 $[^{\circ}C]$")
axis.set_ylabel("TEMPERATURE_2 $[^{\circ}C]$")
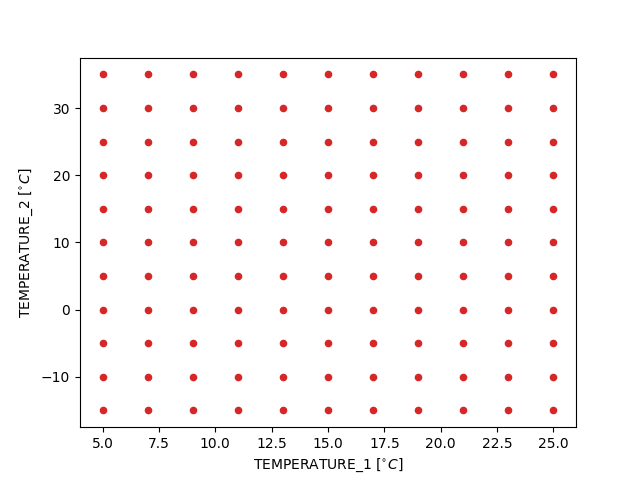
Сетка значений параметров в результате работы функции get_cartesian_product модуля repeat.parametric_study#
На следующем шаге необходимо создать общую таблицу design_cases, пригодную для сохранения всех расчётных случаев, содержащих граничные условия по температурам и значения результатов расчёта тепловых потоков.
design_cases = input_data.copy(deep = True)
design_cases["heat_flux_1"] = pd.NA
design_cases["heat_flux_2"] = pd.NA
design_cases.tail()
Далее требуется выполнить цикл расчётов модели на платформе REPEAT VISION. Для этого создаётся и выполняется функция solve в следующей ячейке.
def solve(input_data, design_cases):
    for i, variables in input_data.iterrows():
        with model as md:
            md.run(variables)
            design_cases.loc[i, "heat_flux_2"] = md.get_results("heat_flux_2").iloc[-1]

solve(input_data, design_cases)
На следующем шаге вычисляется тепловой поток heat_flux_1, в соответствии с требованиями к модели машинного обучения с целью дальнейшей интеграции на платформу REPEAT VISION.
design_cases.loc[:, "heat_flux_1"] = - design_cases.loc[:, "heat_flux_2"]
Далее необходимо сохранить общую таблицу design_cases на случай создания других ML моделей с использованием ранее полученных результатов моделирования.
design_cases.to_csv("heat_transfer_data.csv")
Для отображения результатов расчётов на сетке значений параметров требуется создать вспомогательную функцию трёхмерной визуализации на основе возможностей пакета matplotlib.
def plot_3d_scatter(table):
    fig = plt.figure()
    ax = fig.add_subplot(projection = "3d")
    ax.scatter(
        table["TEMPERATURE_2"],
        table["TEMPERATURE_1"],
        table["heat_flux_2"],
        marker='o',
        c = 'tab:orange'
      )
    ax.set_xlabel("TEMPERATURE_2 $[^{\circ}C]$")
    ax.set_ylabel("TEMPERATURE_1 $[^{\circ}C]$")
    ax.set_zlabel("heat_flux_2 $[W]$")
    plt.show()

plot_3d_scatter(design_cases)
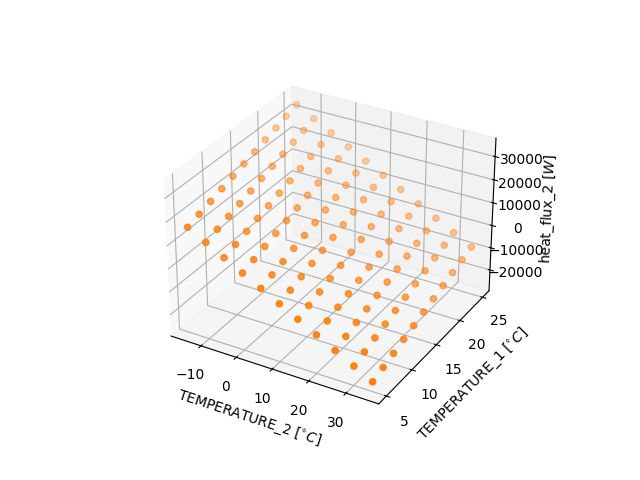
Результаты расчёта теплового потока heat_flux_2 на сетке значений параметров TEMPERATURE_1 и TEMPERATURE_2#
На трёхмерной картине распределения зависимости heat_flux_2 от TEMPERATURE_1 и TEMPERATURE_2 видна линейная зависимость теплового потока от температур, соответствующая функциональным зависимостям блока №1 Теплопроводность, что определяет выбор архитектуры модели машинного обучения, которая будет создаваться в рамках следующего раздела.
4. Создание модели машинного обучения теплопроводности#
Для создания модели машинного обучения требуется выполнить предварительную обработку данных, разделив их на данные для обучения и данные для проверки качества модели.
В следующей ячейке выделяются результаты расчёта тепловых потоков в отдельное имя переменной heat_flux.
heat_flux = design_cases[["heat_flux_1", "heat_flux_2"]]
Далее необходимо создать вспомогательную функцию get_torch_tensors для подготовки структур данных torch.tensor, поскольку модель машинного обучения будет создаваться с помощью фреймворка PyTorch. Необходимо отметить, что в соответствии с требованиями к ML модели используется тип данных torch.double при создании torch.tensor.
def get_torch_tensors(tables : pd.DataFrame):
    total = []
    for table in tables:
        tensors = {}
        for key, values in table.items():
            tensors[key] = torch.tensor(values.to_numpy(), dtype = torch.double).reshape(-1, 1)

        total.append(tensors)

    return total
В следующей ячейке, используя функцию train_test_split библиотеки scikit-learn, выполняется разделение ранее подготовленных данных обучающую выборку и проверочную.
input_data_train, input_data_test, heat_flux_train, heat_flux_test = train_test_split(
    input_data, heat_flux, test_size = 0.33, random_state = 42
    )
На следующем шаге выполняется создание модели машинного обучения с применением фреймворка PyTorch.
 1class LinearModel(nn.Module):
 2    def __init__(self, temperature_mean, temperature_std):
 3        super().__init__()
 4        self.linear = nn.Linear(
 5            in_features = 2,
 6            out_features = 1
 7        )
 8        self.temperature_mean = temperature_mean
 9        self.temperature_std = temperature_std
10
11    def forward(self, TEMPERATURE_1, TEMPERATURE_2):
12        x = torch.cat([TEMPERATURE_1, TEMPERATURE_2], dim = 1)
13        x = (x - self.temperature_mean) / self.temperature_std
14        heat_flux_2 = self.linear(x)
15        heat_flux_1 = - heat_flux_2
16        return heat_flux_1, heat_flux_2
Строки 4-7. В модели
LinearModelсоздаётся слой, принимающий 2 параметра (температурные граничные условия) и вычисляющий результат для 1 параметра.Строки 8-9. В модели линейной регрессии используются дополнительные статистические параметры температур: среднее значение
temperature_meanи среднее квадратичное отклонениеtemperature_std.Строка 11. Методу
forwardпринимает два аргумента в качестве входных параметров модели, соответствующих температурным граничным условиям:TEMPERATURE_1иTEMPERATURE_2.Строка 12. Выполняется подготовка исходных параметров. Объединяются температурные параметры в общий тензор для передачи в линейный слой модели. Объединение параметров выполняется по столбцам
dim = 1.Строка 13. Производится нормирование температурных значений на единицу для обеспечения сходимости процесса определения неизвестных коэффициентов модели линейной регрессии.
Строка 14. Выполняется расчёт теплового потока heat_flux_2 в соответствии с постановкой задачи.
Строка 15. Определяется тепловой поток heat_flux_1 в соответствии с требованиями к ML модели для последующей интеграции на платформу REPEAT VISION для обмена данными с блоками библиотеки Теплообмен.
В следующей ячейке выполняется подготовка средних значений и средних квадратичных отклонений температурных граничных условий с помощью метода describe() библиотеки Pandas.
summary = input_data_train.describe()
temperature_mean = torch.tensor(summary.loc["mean"].to_numpy(), dtype = torch.double)
temperature_std = torch.tensor(summary.loc["std"].to_numpy(), dtype = torch.double)
На следующем шаге выполняется преобразование структур данных pandas.DataFrame в структуры torch.tensor с целью дальнейшего использования данных при обучении ML модели.
input_data_train, input_data_test, heat_flux_train, heat_flux_test = get_torch_tensors((
    input_data_train, input_data_test, heat_flux_train, heat_flux_test
))
Далее выполняется процесс обучения ML модели.
 1torch.manual_seed(42)
 2model = LinearModel(temperature_mean, temperature_std).double()
 3criterion = nn.MSELoss()
 4optimizer = optim.SGD(model.parameters(), lr = 0.1)
 5num_epochs = 100
 6model.train()
 7for epoch in tqdm(range(num_epochs)):
 8    optimizer.zero_grad()
 9    outputs = model(**input_data_train)
10    loss = criterion(outputs[1], heat_flux_train["heat_flux_2"])
11    loss.backward()
12    optimizer.step()
Строка 2. Инициализация экземпляра класса модели
LinearModelс переводом модели в режим двойной точности методом.double()в соответствии с требованиями платформы REPEAT VISION к ML модели.Строка 3. Инициализация функции потерь
criterion, использующей среднеквадратичную ошибку.Строка 4. Инициализация оптимизатора
SGDдля обновления параметров модели. Эмпирически определяется значение настройкиlr = 0.1(learning rate).Строка 10. В процессе обучения функция потерь вычисляет невязку по расчётному значению теплового потока heat_flux_2.
В следующей ячейке выполняется оценка качества созданной модели по среднеквадратичной ошибке на проверочной части данных input_data_test и heat_flux_test.
model.eval()
with torch.no_grad():
    predictions = model(**input_data_test)
    mse = criterion(predictions[1], heat_flux_test["heat_flux_2"])
    print(f"Mean Squared Error (MSE): {mse.item():.4f}")
В завершении процесса создания ML модели выполняется сохранение модели машинного обучения в нейтральный формат ONNX, используемый платформой REPEAT VISION для интеграции аппроксимационных моделей с целью их применения в структурном моделировании.
 1torch.onnx.export(
 2    model,
 3    args = (
 4        torch.tensor([[5]], dtype = torch.double),
 5        torch.tensor([[-15]], dtype = torch.double)
 6    ),
 7    f = "ml_heat_transfer.onnx",
 8    input_names = ["TEMPERATURE_1", "TEMPERATURE_2"],
 9    output_names = ["heat_flux_1", "heat_flux_2"],
10    )
Строка 2. Функции
torch.onnx.export()первым аргументом передаётся ранее обученная модельmodel.Строки 3-6. Именованному аргументу
argsпередаются значения граничных условий по температурам, используемые по-умолчанию. В качестве структуры данных используетсяtorch.tensorразмерностью 1x1 с типомtorch.doubleв соответствии с требованиями платформы REPEAT VISION к ML модели.Строки 7. Именованному аргументу
fприсваивается имя сохраняемого файла формата ONNX для последующего использования на платформе REPEAT VISION.Строки 8. Именованному аргументу
input_namesприсваивается список имён граничных условий по температурам для их удобного отображения на входных портах блока на платформе REPEAT VISION.Строки 9. Именованному аргументу
output_namesприсваивается список имён результатов расчёта тепловых потоков для их удобного отображения на выходных портах блока на платформе REPEAT VISION.
5. Интеграция модели машинного обучения на платформу REPEAT VISION#
В завершении работы требуется загрузить файл ML модели ml_heat_transfer.onnx на платформу REPEAT VISION с помощью блока Аппроксимационная модель (Теплообмен) и преобразовать исходный проект к виду, представленному ниже.
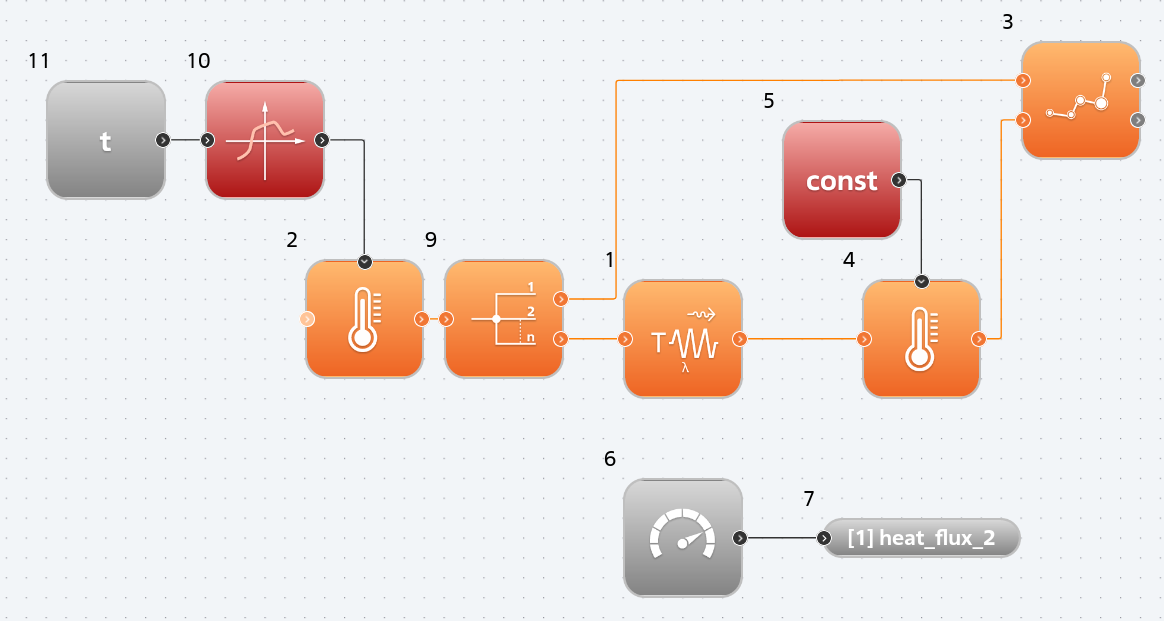
Схема проверки модели машинного обучения для расчёта теплового потока в стенке детали изделия.#
Проект, изображённый выше, позволяет выполнить тестирование модели машинного обучения, содержащейся в блоке №8 Аппроксимационная модель (Теплообмен).
Подсказка
Тестирование ML модели выполняется для независимой оценки её качества в соответствии с выбранными критериями качества модели.
Проект должен использовать следующие настройки:
Время моделирования \([с]\) |
Шаг интегрирования \([мс]\) |
Шаг дискретизации \([мc]\) |
|---|---|---|
0.5 |
20 |
20 |
Блок №10 Нелинейная функция от одного параметра предназначен для подготовки новых данных по температуре TEMPERATURE_1, не входящих в обучающую выборку:
Время моделирования \([с]\) |
Температура \([^{\circ}C]\) |
|---|---|
0.1 |
2 |
0.2 |
10 |
0.3 |
35 |
0.4 |
27 |
0.5 |
1 |
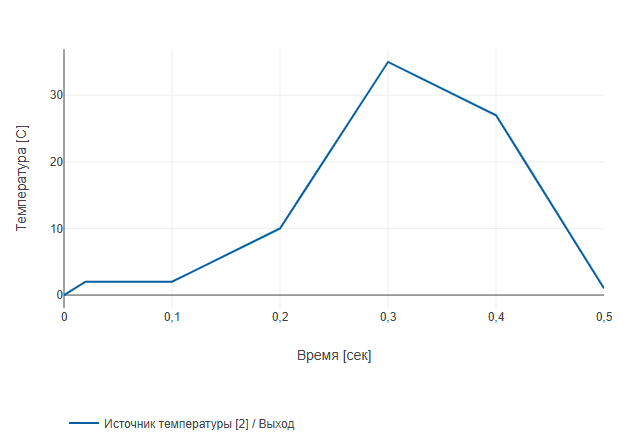
Изменение граничных условий по температуре блоком Нелинейная функция от одного параметра.#
Для тестирования ML модели теплопроводности эталонные расчётные данные теплового потока формирует блок №1 Теплопроводность.
На следующем шаге формируются зависимости тепловых потоков от времени для сравнительного анализа результатов расчёта ML модели и блока №1 Теплопроводность.
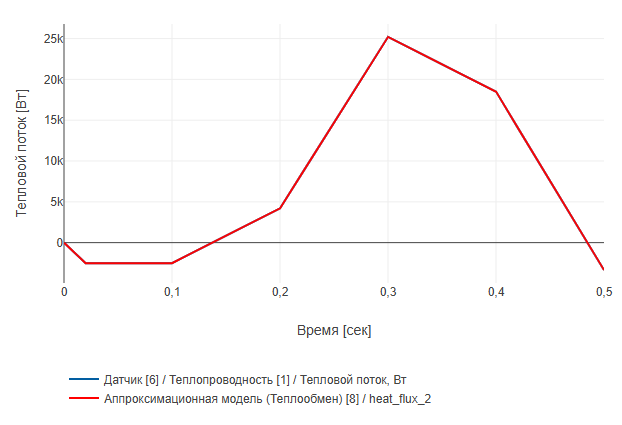
Зависимости тепловых потоков от времени для аппроксимационной модели и блока Теплопроводность.#
На графиках, приведённых выше, видно совпадение значений тепловых потоков, рассчитанных ML моделью, с эталонными значениями, вычисленных блоком №1 Теплопроводность.
6. Выводы#
В результате выполнения данного практического руководства:
Вы познакомились с процессом подготовки модели машинного обучения для аппроксимации стационарного процесса переноса тепла теплопроводностью в стенке детали с помощью платформы REPEAT VISION и PyTorch;
Вы узнали, как интегрировать на платформу REPEAT VISION ML модель с помощью блока Аппроксимационная модель (Теплообмен) для решения задач теплообмена и теплопередачи;
Вы познакомились с тестированием модели машинного обучения как в процессе её создания, так и в процессе её эксплуатации на платформе REPEAT VISION.