

Модель машинного обучения максимальных напряжений в отводе газопровода-шлейфа, возникающих при эрозионном износе#
В практическом руководстве приведено подробное описание создания модели машинного обучения для аппроксимации максимальных напряжений, действующих в отводе и возникающих при эрозионном износе внутренней поверхности отвода в процессе эксплуатации газопровода-шлейфа.
В процессе чтения руководства вы узнаете:
Где и зачем нужен газопровод-шлейф?
Цель и задачи моделирования процесса эксплуатации газопроводов-шлейфов;
Основные шаги создания модели машинного обучения (ML модель) с помощью Python для оценки процесса эрозии;
Как использовать ML модель с газодинамической моделью газопровода-шлейфа на платформе REPEAT VISION.
1. Общая информация о газопроводах-шлейфах#
Газопроводы-шлейфы (рисунок ниже) используются на газовых месторождениях и предназначены для транспорта газа от скважин до установки комплексной подготовки газа (УКПГ). Газ, после необходимой подготовки к транспорту на УКПГ, поступает в магистральный газопровод.
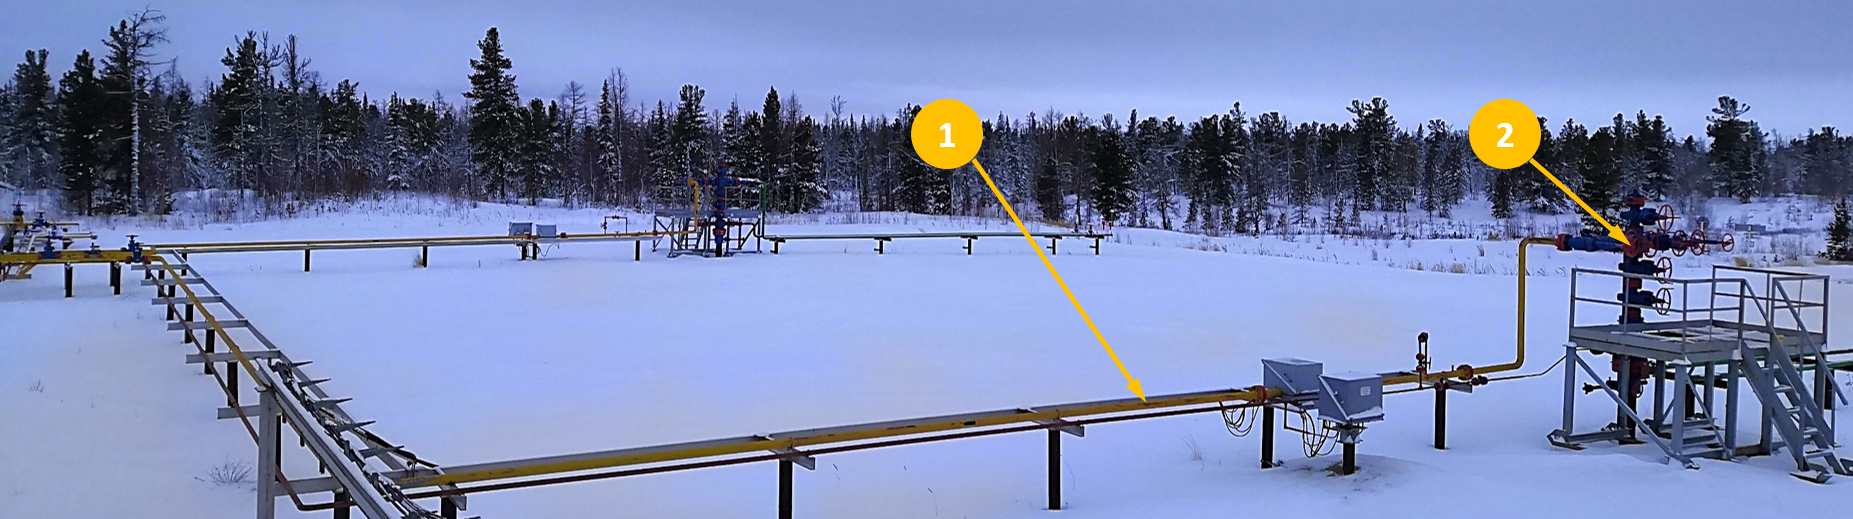
Газопровод-шлейф на кусте двух газовых скважин.#
Газопровод-шлейф (№1 на рисунке выше) в процессе эксплуатации подвержен следующим воздействиям:
Внутренняя поверхность газопровода нагружена давлением и температурой газа;
Наружная поверхность газопровода нагружена переменной температурой внешней среды.
1.1. Проблема эрозионного износа газопровода-шлейфа#
Процесс эксплуатации газовой скважины (№2 на рисунке выше) может сопровождаться выносом воды, содержащей механические примеси, что вызывает эрозионный износ внутренней поверхности газопровода-шлейфа.
Вынос воды, содержащей небольшое количество механических примесей, может происходить постоянно, что позволяет создавать несложные полуэмпирические аналитические методики прогнозирования эрозионного износа.
Также эрозионный износ может носить циклический характер с периодическим выносом воды и механических примесей.
Бывают и очень опасные внезапные выносы механических примесей с большим количеством воды, которые могут приводить к непредвиденному и значительному износу элементов газопровода-шлейфа.
Наиболее уязвимым элементом газопровода-шлейфа является первый отвод, если считать от фонтанной арматуры газовой скважины (№2 на рисунке выше).
1.2. Способы снижения риска#
Для снижения риска инцидентов и аварий вследствие эрозионного износа газопровода-шлейфа требуется решение комплексной задачи, включающей:
Применение физико-математического моделирования процесса эксплуатации трубопроводной системы и его системы управления;
Применение автоматизированных средств диагностики технического состояния элементов газопровода;
Внедрение автоматизированных систем управления процессом эксплуатации газовых скважин, использующих результаты оценки математического моделирования актуального технического состояния газопровода.
2. Средства диагностики технического состояния газопроводов-шлейфов#
Автоматизированные средства диагностики технического состояния элементов газопровода-шлейфа, необходимые для контроля эрозионного процесса включают следующие системы:
Системы контроля расхода;
Датчики температуры внешней среды и системы контроля давления и температуры газа;
Интрузивные датчики измерения эрозии и акустические системы контроля песка;
Системы точечной и распределённой толщинометрии.
3. Цель и задачи моделирования процесса эксплуатации газопроводов-шлейфов#
Цель. Повышение производственной эффективности компании и предупреждение аварий промысловых объектов.
Задачи моделирования:
Расчёт параметров прочности на основании актуальных данных диагностики технического состояния газопроводов-шлейфов;
Расчёт параметров системы сбора на соответствие техническому проекту разработки месторождения;
Обеспечение максимальной добычи газа в пиковый сезонный период (зима, спрос) и минимальной добычи (лето);
Обеспечение оптимальных параметров работы системы сбора при незапланированном отключении скважин или при режимах работы скважин, не соответствующих проектным;
Определение параметров системы сбора при изменении входных параметров системы подготовки газа и конденсата.
Способ решения задачи №1 приводится в следующем разделе. Решение остальных задач сводится к моделированию трубопроводных систем с помощью REPEAT VISION и решению задач глобальной и локальной оптимизации.
4. Описание задачи#
Выполнить оценку напряжённо-деформированного состояния (НДС) отвода на основании исходных данных и граничных условий.
Модель машинного обучения создаётся на основе таблицы данных результатов расчётов статической прочности модели отвода. Каждая строка в таблице данных является отдельным расчётным случаем. Каждый расчётный случай включает:
Исходные данные и граничные условия:
Минимальная толщина стенки,
Давление газа,
Температура газа,
Температура окружающей среды,
Результат расчёта НДС: Максимальные напряжения по Мизесу.
Расчётные случаи основаны на технологическом регламенте конкретного месторождения:
Давление газа изменяется в диапазоне: от 8.5 до 6.0 \([МПа]\),
Температура газа изменяется в диапазоне: от 7 до 20 \([^{\circ}C]\),
Температура окружающей среды изменяется в диапазоне: от -55 до 40 \([^{\circ}C]\),
Расчётные случаи включают минимальные толщины стенки отвода от 6.45 до 4.9 \([мм]\).
Результатом расчёта статической прочности одного из расчётных случаев является распределение напряжений по Мизесу, приведённое на рисунке ниже.
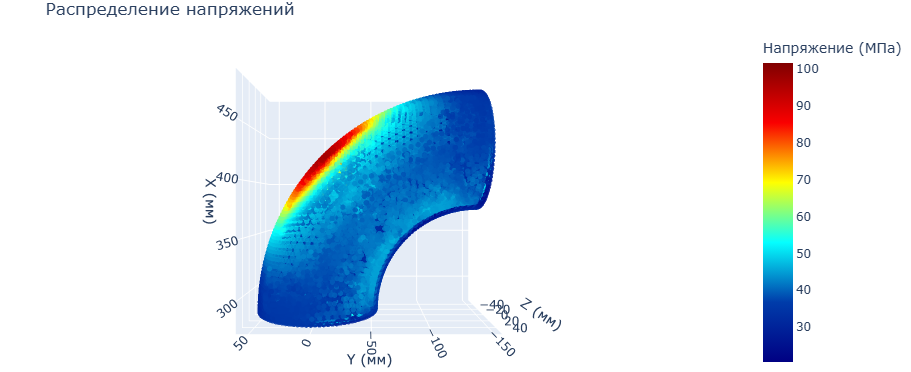
Пример распределений напряжений по Мизесу в отводе.#
Для каждого результата расчёта напряжений, действующих в отводе, приведённых на рисунке выше, выбирается максимальное значение и заносится в таблицу результатов расчётов.
5. Подготовка таблицы расчётных случаев#
Расчёт статической прочности отвода выполняется в программном комплексе, реализующего метод конечных элементов (МКЭ).
5.1. Модель статической прочности#
Для определения НДС отвода учитывалось влияние всего газопровода-шлейфа и связанных с ним опорных конструкций куста двух газовых скважин.
Линейные участки трубопроводов газопровода-шлейфа и опорные конструкции моделировались в балочном приближении.
Отводы и тройниковые соединения моделировались с помощью объёмных КЭ.
5.2. Основные этапы подготовки данных#
Подготовка таблицы расчётных случаев сводится к автоматизированному процессу параметрических исследований статической прочности отвода, который сам по себе является отдельной инженерной задачей.
Подсказка
Если вам необходимо больше информации и навыков выполнения параметрических исследований, то ознакомьтесь с нашим практическим руководством на данную тему.
Основные этапы процесса параметрических исследований приведены на рисунке ниже.
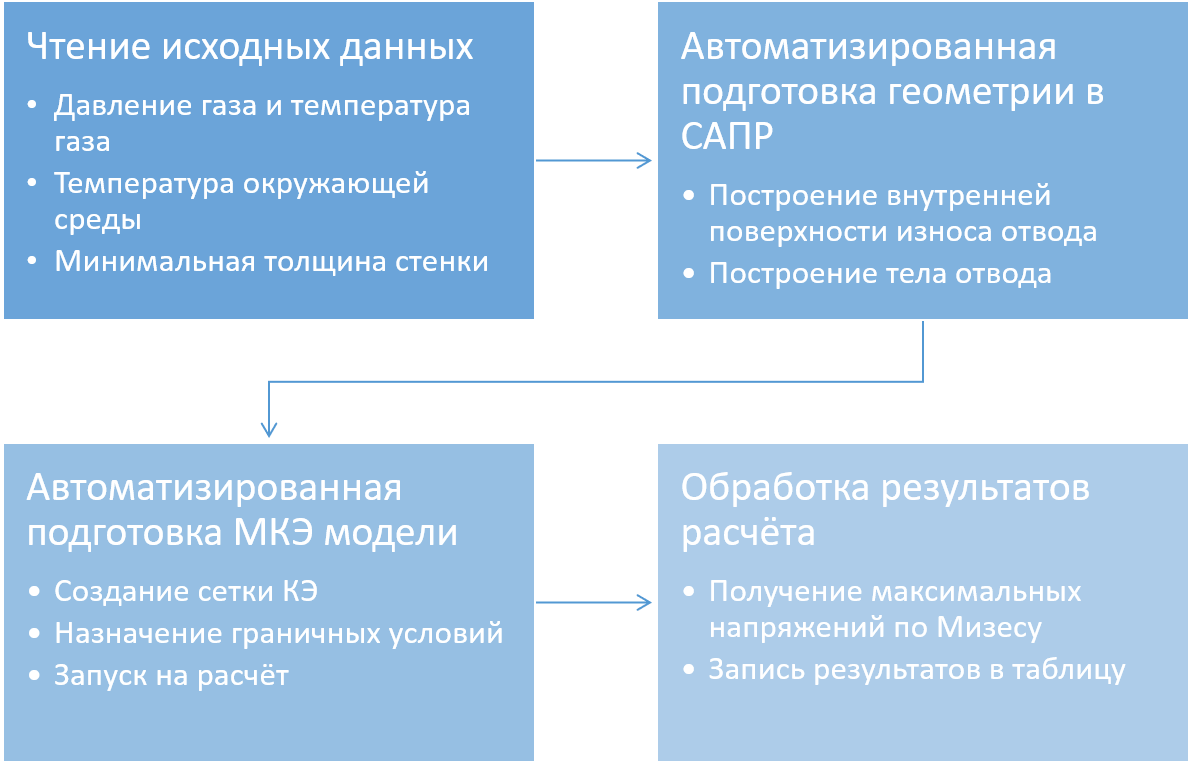
Процесс подготовки данных на основе моделирования статической прочности отвода.#
Данный процесс повторялся в рабочем цикле параметрических исследований примерно 6000 раз для получения необходимой таблицы расчётных случаев с целью последующего создания модели машинного обучения.
6. Построение модели нейронной сети#
Примечание
Вы можете скачать файл Jupyter ноутбука, а также файл requirements.txt для создания необходимого виртуального окружения, если хотите быстро выполнить код данного практического руководства на вашем персональном компьютере.
Дополнительно вам понадобятся данные для обучения модели и (не обязательно) данные для визуализации одного результата расчёта.
Также вы можете скачать файл модели и сразу использовать её в проекте на платформе REPEAT VISION с помощью блока Аппроксимационная модель.
Для написания модели будет использован язык Python и фреймворк PyTorch, поэтому необходимы базовые знания этого языка и навыки работы с PyTorch.
Важно
Обратите внимание, что для установки версии PyTorch, поддерживающей работу с GPU и совместимой с Вашей версией CUDA, необходимо посетить официальный сайт.
Кроме того, для решения задачи используется множество общепринятый для соответствующих подзадач библиотек:
NumPy и Pandas — работа с массивами, линейная алгебра и обработка табличных данных соответственно.
Matplotlib, Seaborn — визуализация статических графиков для отслеживания качества работы модели.
Plotly — интерактивные графики, для наглядного представления объекта исследования.
scikit-learn — подсчет метрик и разбиение данных.
Перед началом подготовки ML модели необходимо установить Python, а также требуется установить пакеты для работы с данными и создания ML модели. Для этого необходимо выполнить в командной строке вашего компьютера следующие команды и продолжить работу в Jupyter ноутбуке.
mkdir ml_branch_stress
cd ml_branch_stress
python -m venv repeat_ml.
source repeat_ml/bin/activate
python -m pip install numpy pandas scikit-learn onnx onnxscript
python -m pip install seaborn matplotlib plotly
python -m pip install jupyterlab tqdm ipywidgets netron
python -m pip install torch --index-url https://download.pytorch.org/whl/cpu

jupyter lab
mkdir ml_branch_stress
cd ml_branch_stress
python -m venv repeat_ml.
repeat_ml\Scripts\Activate.ps1
python -m pip install numpy pandas scikit-learn onnx onnxscript
python -m pip install seaborn matplotlib plotly
python -m pip install jupyterlab tqdm ipywidgets netron
python -m pip install torch --index-url https://download.pytorch.org/whl/cpu

jupyter lab
В первую очередь импортируем необходимые библиотеки для создания нейронных сетей, построения визуализаций и последующего импорта в формат ONNX.
 1import numpy as np
 2import pandas as pd
 3
 4import seaborn as sns
 5import matplotlib.pyplot as plt
 6import plotly.graph_objects as go
 7
 8import torch
 9import torch.nn as nn
10import torch.optim as optim
11from torch.utils.data import Dataset, DataLoader
12
13from sklearn.model_selection import train_test_split
14from sklearn.metrics import (mean_squared_error,
15                             mean_absolute_error,
16                             mean_absolute_percentage_error,
17                             r2_score)
18
19from tqdm.notebook import tqdm
20from typing import Tuple, List, Dict, Union
Для улучшения воспроизводимость и использования доступного устройства, необходимо зафиксировать генерацию случайных чисел и доступность графического ускорителя.
1SEED = 42
2torch.manual_seed(SEED)
3np.random.seed(SEED)
4
5device = torch.device('cuda' if torch.cuda.is_available() else 'cpu')
6print(device)
6.1. Исследование данных#
Для наглядного отображения распределения напряжений в отводе визуализируем трехмерное распределение точек используя интерактивную 3D-визуализация с помощью Plotly.
 1def branch_plot(df: pd.DataFrame) -> go.Figure:
 2    """
 3    Создает 3D визуализацию распределения напряжений.
 4
 5    Параметры:
 6        df: pd.DataFrame
 7            DataFrame с данными о координатах и напряжениях
 8    Возвращает:
 9        go.Figure: Объект графика Plotly
10    """
11    marker_config = dict(
12        size=3,
13        color=df['Stress'],
14        colorscale='Jet',
15        opacity=0.8,
16        colorbar=dict(title="Напряжение (МПа)")
17    )
18    hover_template = (
19        '<b>Узел</b>: %{customdata}<br>'
20        '<b>X</b>: %{x:.2f} мм<br>'
21        '<b>Y</b>: %{y:.2f} мм<br>'
22        '<b>Z</b>: %{z:.2f} мм<br>'
23        '<b>Напряжение</b>: %{marker.color:.2f} МПа'
24    )
25    fig = go.Figure(
26        data=[
27            go.Scatter3d(
28                x=df['X'],
29                y=df['Y'],
30                z=df['Z'],
31                mode='markers',
32                marker=marker_config,
33                hovertemplate=hover_template,
34                customdata=df['Node']
35            )
36        ]
37    )
38    scene_config = dict(
39        xaxis_title='X (мм)',
40        yaxis_title='Y (мм)',
41        zaxis_title='Z (мм)',
42        aspectmode='data',
43        camera=dict(
44            eye=dict(x=0, y=0, z=2.5),
45            center=dict(x=0, y=0, z=0),
46            up=dict(x=0, y=1, z=0)
47        )
48    )
49    margin_config = dict(l=0, r=0, b=0, t=30)
50    fig.update_layout(
51        title='Распределение напряжений',
52        scene=scene_config,
53        margin=margin_config
54    )
55
56    return fig
В результате, для произвольно выбранного файла с результатами численного эксперимента, будет построен набор точек, цвет которых будет отображать величину напряжения, а в качестве осей будут использованы привычные \( X, Y, Z \). Проведем построение визуализации выполнением следующего кода:
1df = pd.read_csv('stress_branch.csv')
2fig = branch_plot(df)
3fig.show()
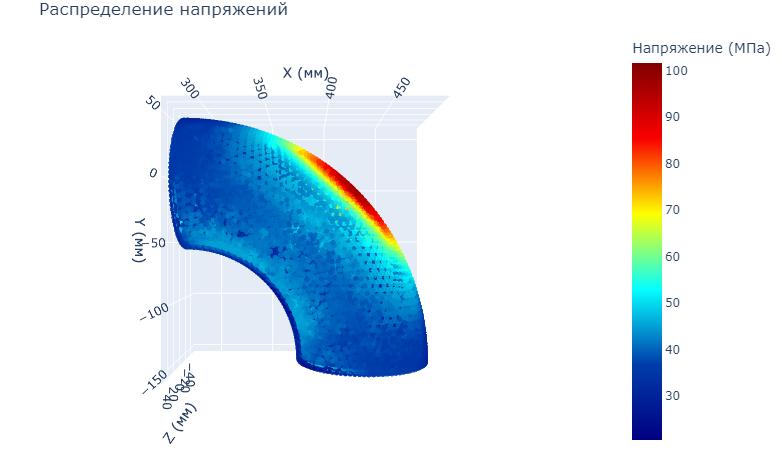
Распределение напряжений в отводе.#
В результате обработки такого рода файлов, необходимы для обучения данные были агрегированы в таблицу. Из всего множества значений напряжений по Мизесу, которые рассчитывались в отводе, в таблицу записывалось максимальное значение.
Итогова таблица для постановки задачи регрессии имеет следующие параметры:
Входные параметры (признаки):
Давление (pressure), меняется в диапазоне: 6.0 - 8.5 \([МПа]\).
Температура газа (gas_temperature), меняется в диапазоне: 7.0 - 20.0 \([^{\circ}C]\).
Температура окружающей среды (ambient_temperature), меняется в диапазоне: -55.0 - 40.0 \([^{\circ}C]\).
Минимальная толщина стенки (wall_thickness_min), меняется в диапазоне: 4.90 - 6.45 \([мм]\).
Целевая переменная:
Максимальное напряжение по Мизесу в конструкции (stress_max), меняется в диапазоне: 45.31 - 140.40 \([МПа]\).
1df = pd.read_csv('branch_data.csv')
2df.describe()
Для отображения данных в виде непосредственно таблицы, с разделением столбцов на признаки и целевую переменную можно использовать следующий код:
1features = ['pressure', 'gas_temp', 'ambient_temp', 'wall_thickness']
2target = 'stress_max'
3
4df[features + [target]].head()
6.2. Подготовка данных#
Для эффективной работы с данными в PyTorch используется специальный класс StressDataset, который наследуется от torch.utils.data.Dataset. Родительский класс является абстрактным и требует реализации двух основных методов: __len__() и __getitem__(). В итоге, этот класс выполняет несколько важных функций:
Инкапсулирует логику загрузки и предобработки данных. В данном случае - преобразует данные в
torch.Tensorи переносит их на необходимое устройство.Обеспечивает единообразный интерфейс доступа к данным, упрощающий работу с моделью, соответствующей требованиям для интеграции в REPEAT VISION.
Позволяет эффективно работать с большими наборами данных, загружая их порциями, что реализовано в данном случае на примере признаков.
Упрощает интеграцию с DataLoader для разбиения на батчи и перемешивания данных.
StressDataset# 1class StressDataset(Dataset):
2 """
3 Класс датасета для обучения модели.
4 """
5 def __init__(
6 self,
7 X: np.ndarray,
8 y: np.ndarray,
9 device: torch.device = torch.device('cpu')
10 ) -> None:
11 """
12 Инициализация набора данных.
13
14 Параметры:
15 X: np.ndarray
16 Массив входных признаков
17 y: np.ndarray
18 Массив целевых значений
19 device: torch.device
20 Устройство для вычислений
21 """
22 super().__init__()
23 self.device = device
24 self.X = X
25 self.y = torch.FloatTensor(y, device=self.device).reshape(-1, 1)
26
27 def __len__(self) -> int:
28 """
29 Методы получения количества элементов.
30
31 Возвращает:
32 int: Количество элементов
33 """
34 return len(self.X)
35
36 def __getitem__(self, idx: int) -> Tuple[Tuple[torch.Tensor, ...], torch.Tensor]:
37 """
38 Возвращает пару (признаки, целевое значение) для заданного индекса.
39
40 Параметры:
41 idx: int
42 Индекс образца
43
44 Возвращает:
45 Tuple[Tuple[torch.Tensor, ...], torch.Tensor]:
46 Кортеж из кортежа признаков и целевого значения
47 """
48 return (
49 tuple(torch.Tensor([feature], device=self.device)
50 for feature in self.X[idx]),
51 self.y[idx]
52 )
Важно
Важно отметить, что каждый признак возвращается отдельным тензором, что важно для экспорта в ONNX и интеграции с REPEAT VISION.
Воспользуемся созданным классом для подготовки данных для обучения.
 1X = df[features].values
 2y = df[target].values
 3
 4X_train, X_test, y_train, y_test = train_test_split(
 5    X, y,
 6    test_size=0.2,
 7    random_state=42
 8)
 9
10train_dataset = StressDataset(X_train, y_train, device)
11test_dataset = StressDataset(X_test, y_test, device)
12
13batch_size = 64
14train_loader = DataLoader(
15    train_dataset,
16    batch_size=batch_size,
17    shuffle=True
18)
19test_loader = DataLoader(
20    test_dataset,
21    batch_size=batch_size,
22    shuffle=False
23)
В результате выполнения этого кода происходит:
Строки 1-2. Отделение численных значений признаков и целевой переменной.
Строки 4-8. Разбиение на обучающую и тестовую выборки.
Строка 10-11. Создание экземпляров класса
StressDatasetдля обучения и тесторванияСтрока 13-23. Создание экземпляров класса
DataLoaderдля эффективной загрузки данных батчами.
6.3. Архитектура нейронной сети#
В задаче заданы 4 входных признака: давление (pressure), температура газа (gas_temp), температура окружающей среды (ambient_temp) и толщина стенки (wall_thickness). Все они склеиваются в один вектор размера 4. Выходом же является одно численное значение (предсказанное максимальное напряжение), то есть задача является примером задачи регрессии:
где:
где:
\(p\) - давление;
\(t_g\) - температура газа;
\(t_a\) - температура окружающей среды;
\(w\) - толщина стенки;
\(\sigma_{max}\) - максимальное напряжение.
Для табличных данных могут быть применены различные модели, от классического машинного обучения до глубоких нейронных сетей. В данном случае используется MLP (Multi Layer Perceptron) модель.
Архитектура модели представляет собой трехслойный MLP с фиксированной глубиной, где размер скрытых слоев настраивается при инициализации. Такая структура обеспечивает достаточную емкость для аппроксимации нелинейных зависимостей в данных.
Матричное представление трехслойной MLP модели с 4 входными каналами, 1 выходным и скрытым состоянием \( h \):
где:
\(x \in \mathbb{R}^4\) - входной вектор признаков
\(W_1 \in \mathbb{R}^{h \times 4}, b_1 \in \mathbb{R}^{h}\) - веса и смещения первого слоя
\(W_2 \in \mathbb{R}^{h \times h}, b_2 \in \mathbb{R}^{h}\) - веса и смещения второго слоя
\(W_3 \in \mathbb{R}^{h \times h}, b_3 \in \mathbb{R}^{h}\) - веса и смещения третьего слоя
\(W_4 \in \mathbb{R}^{1 \times h}, b_4 \in \mathbb{R}\) - веса и смещения выходного слоя
\(y \in \mathbb{R}\) - выходное значение (предсказанное напряжение)
В модели применено несколько идей:
Для стабилизации обучения модель использует предварительно вычисленные статистики (
meanиstd) из тренировочного набора данных. Нормализация входных признаков в методеforwardпозволяет привести каждый пример к единому распределению, не требуя отдельного нормализатора, что осложнило бы импорт в REPEAT VISION.В качестве регуляризации применяется комбинация
Dropout, L2-регуляризации (weight decay) и ранней остановкой (early stopping). Функция активации ReLU выбрана на основе анализа данных, хотя альтернативно можно использовать и более сглаженные варианты. Для инициализации весов используется метод Кайминга, который стабилизирует дисперсию выходов слоев и предотвращает проблемы с градиентами. Смещения инициализируются нулями, так как они быстро обучаются сами.Вместо популярного
BatchNormпредпочтение отданоLayerNorm, что обеспечивает более стабильное обучение на консистентных данных при существенных статистических различиях между батчами.
Все описанные идеи реализованы в классе StressNet. Такая архитектура обеспечивает хороший баланс между емкостью модели и регуляризацией, что особенно важно при работе с малым, как в этой задаче, набором данных.
StressNet# 1class StressNet(nn.Module):
2 """
3 Нейронная сеть.
4 """
5 def __init__(
6 self,
7 input_size: int = 4,
8 hidden_size: int = 32,
9 mean: torch.Tensor = torch.zeros(4),
10 std: torch.Tensor = torch.ones(4),
11 dropout_rate: float = 0.2
12 ) -> None:
13 """
14 Инициализация модели.
15
16 Параметры:
17 input_size: int
18 Размер входного слоя
19 hidden_size: int
20 Размер скрытых слоев
21 mean: torch.Tensor
22 Средние значения для нормализации
23 std: torch.Tensor
24 Стандартные отклонения для нормализации
25 dropout_rate: float
26 Вероятность отключения нейронов
27 """
28 super().__init__()
29
30 self.fc1 = nn.Linear(input_size, hidden_size)
31 self.norm1 = nn.LayerNorm(hidden_size)
32 self.fc2 = nn.Linear(hidden_size, hidden_size)
33 self.norm2 = nn.LayerNorm(hidden_size)
34 self.fc3 = nn.Linear(hidden_size, hidden_size)
35 self.norm3 = nn.LayerNorm(hidden_size)
36 self.out = nn.Linear(hidden_size, 1)
37
38 self.act = nn.ReLU()
39 self.dropout = nn.Dropout(dropout_rate)
40
41 self.mean = mean
42 self.std = std
43
44 self.apply(self._init_weights)
45
46 def _init_weights(self, module: nn.Module) -> None:
47 """
48 Инициализация весов слоев.
49
50 Параметры:
51 module: nn.Module
52 Модуль для инициализации весов
53 """
54 if isinstance(module, nn.Linear):
55 nn.init.kaiming_uniform_(
56 module.weight,
57 nonlinearity='relu'
58 )
59 nn.init.zeros_(module.bias)
60
61 def forward(
62 self,
63 pressure: torch.Tensor,
64 gas_temp: torch.Tensor,
65 ambient_temp: torch.Tensor,
66 wall_thickness: torch.Tensor
67 ) -> torch.Tensor:
68 """
69 Прямой проход через сеть.
70
71 Параметры:
72 pressure: torch.Tensor
73 Давление
74 gas_temp: torch.Tensor
75 Температура газа
76 ambient_temp: torch.Tensor
77 Температура окружения
78 wall_thickness: torch.Tensor
79 Толщина стенки
80
81 Возвращает:
82 torch.Tensor: Предсказанное значение максимального напряжения
83 """
84 batch_size = pressure.shape[0]
85
86 x = torch.cat([
87 pressure.view(batch_size, -1),
88 gas_temp.view(batch_size, -1),
89 ambient_temp.view(batch_size, -1),
90 wall_thickness.view(batch_size, -1)
91 ], dim=1)
92
93 x = (x - self.mean) / self.std
94
95 x = self.fc1(x)
96 x = self.norm1(x)
97 x = self.act(x)
98 x = self.dropout(x)
99
100 x = self.fc2(x)
101 x = self.norm2(x)
102 x = self.act(x)
103 x = self.dropout(x)
104
105 x = self.fc3(x)
106 x = self.norm3(x)
107 x = self.act(x)
108 x = self.dropout(x)
109
110 return self.out(x)
Строки 30-39. Объявление трех слоев с LayerNorm и Dropout для регуляризации.
Строки 41-42. Поскольку входные данные нормализуются внутри модели,
meanиstdпередаются в конструктор.Строки 44. Применяется начальная инициализация весов (строки 46-59).
Строки 61-110. Основной метод,
forward, принимает необходимые входные параметры, объединяет их в один тензор и затем пропускает его через все слои в необходимом порядке.
После определения архитектуры модели, необходимо инициализировать саму модель и настроить оптимизатор и критерий (функцию потерь).
В данном случае используется следующая конфигурация:
Размер скрытого слоя (
hidden_size) установлен на 512 нейроновКоэффициент прореживания (
dropout_rate) равен 0.2Для нормализации входных данных используются статистики из обучающего набора
В качестве функции потерь выбрано среднеквадратичное отклонение (MSE)
Оптимизатор AdamW с коэффициентом обучения 5e-4 и L2-регуляризацией 1e-4
 1hidden_size = 512
 2dropout_rate = 0.2
 3
 4stats = pd.DataFrame(df[features])
 5mean = torch.tensor(stats.mean().values, dtype=torch.float32)
 6std = torch.tensor(stats.std().values,  dtype=torch.float32)
 7
 8model = StressNet(
 9    input_size=len(features),
10    mean=mean,
11    std=std,
12    hidden_size=hidden_size,
13    dropout_rate=dropout_rate
14)
15
16criterion = nn.MSELoss()
17optimizer = optim.AdamW(model.parameters(), lr=5e-4, weight_decay=1e-4)
6.4. Обучение модели#
Функция train_model предназначена для обучения нейронной сети с использованием метода градиентного спуска. Вот основные компоненты и этапы работы функции:
Подготовка:
Перенос модели на указанное устройство.
Инициализация списков для отслеживания потерь.
Настройка ранней остановки (early stopping).
Цикл обучения:
Обучение на тренировочных данных.
Валидация на проверочных данных.
Отслеживание лучшей модели.
Проверка условий ранней остановки.
Мониторинг:
Отслеживание значения функции потерь.
Сохранение лучшей модели.
Вывод прогресса обучения.
Данная реализация обеспечивает стабильное обучение модели с возможностью ранней остановки для предотвращения переобучения.
train_model# 1def train_model(
2 model: nn.Module,
3 train_loader: DataLoader,
4 val_loader: DataLoader,
5 criterion: nn.Module,
6 optimizer: optim.Optimizer,
7 epochs: int,
8 device: torch.device = torch.device('cpu'),
9 patience: int = 20
10) -> Tuple[nn.Module, List[float], List[float]]:
11 """
12 Обучает модель нейронной сети.
13
14 Параметры:
15 model: nn.Module
16 Модель нейронной сети для обучения
17 train_loader: DataLoader
18 Загрузчик данных для обучающей выборки
19 val_loader: DataLoader
20 Загрузчик данных для валидационной выборки
21 criterion: nn.Module
22 Функция потерь
23 optimizer: optim.Optimizer
24 Оптимизатор для обновления весов
25 epochs: int
26 Количество эпох обучения
27 device: torch.device
28 Устройство для вычислений (CPU/GPU)
29 patience: int
30 Количество проведенных эпох без улучшения, достаточное для ранней остановки обучения
31
32 Возвращает:
33 Tuple[nn.Module, List[float], List[float]]: Обученная модель,
34 список потерь на обучающей выборке, список потерь на валидационной выборке
35 """
36 model.to(device)
37
38 train_losses = []
39 val_losses = []
40
41 best_val_loss = float('inf')
42 no_improvement = 0
43 best_model_state = None
44
45 for epoch in tqdm(range(epochs), desc='Training'):
46 model.train()
47 train_loss = 0.0
48
49 for inputs, targets in train_loader:
50 optimizer.zero_grad()
51
52 outputs = model(*inputs)
53 loss = criterion(outputs, targets)
54
55 loss.backward()
56 optimizer.step()
57
58 train_loss += loss.item() * targets.size(0)
59
60 train_loss = train_loss / len(train_loader.dataset)
61 train_losses.append(train_loss)
62
63 model.eval()
64 val_loss = 0.0
65
66 with torch.no_grad():
67 for inputs, targets in val_loader:
68 outputs = model(*inputs)
69 loss = criterion(outputs, targets)
70
71 val_loss += loss.item() * targets.size(0)
72
73 val_loss = val_loss / len(val_loader.dataset)
74 val_losses.append(val_loss)
75
76 if epoch % 10 == 0:
77 print(
78 f'Epoch {epoch+1}/{epochs}, '
79 f'Train Loss: {train_loss:.6f}, '
80 f'Val Loss: {val_loss:.6f}'
81 )
82
83 if val_loss < best_val_loss:
84 best_val_loss = val_loss
85 no_improvement = 0
86 best_model_state = model.state_dict().copy()
87 else:
88 no_improvement += 1
89 if no_improvement >= patience:
90 print(f'Early stopping at epoch {epoch+1}')
91 model.load_state_dict(best_model_state)
92 break
93
94 return model, train_losses, val_losses
Строки 49-58. Основной цикл обучения с вычислением потерь на тренировочном наборе данных.
Строки 66-71. Валидация модели и вычисление потерь на валидационном наборе.
Строки 83-92. Логика ранней остановки и сохранения лучшей модели.
Для обучения модели необходимо вызвать функцию train_model передав ей корректно созданные ранее параметры и сущности.
train_model# 1model, train_losses, val_losses = train_model(
2 model=model,
3 train_loader=train_loader,
4 val_loader=test_loader,
5 criterion=criterion,
6 optimizer=optimizer,
7 epochs=500,
8 device=device,
9 patience=10
10)
6.5. Оценка модели#
Функция evaluate_model предназначена для оценки производительности обученной нейронной сети на тестовом наборе данных. Она выполняет следующие действия:
Подготовка модели:
Переводит модель в режим оценки (
model.eval()).Отключает вычисление градиентов для оптимизации памяти.
Обработка данных:
Проходит по всем батчам в DataLoader.
Получает предсказания модели.
Собирает реальные значения и предсказания в списки.
Расчет метрик:
MSE (Mean Squared Error) - средняя квадратичная ошибка.
RMSE (Root Mean Squared Error) - корень из средней квадратичной ошибки.
MAPE (Mean Absolute Percentage Error) - средняя абсолютная процентная ошибка.
MAE (Mean Absolute Error) - средняя абсолютная ошибка.
R² (R-squared) - коэффициент детерминации.
evaluate_model# 1def evaluate_model(
2 model: nn.Module,
3 data_loader: DataLoader,
4 criterion: nn.Module,
5 device: torch.device = torch.device('cpu')
6) -> Dict[str, Union[float, np.ndarray]]:
7 """
8 Оценивает производительность модели на заданном наборе данных.
9
10 Параметры:
11 model: nn.Module
12 Модель PyTorch для оценки
13 data_loader: DataLoader
14 DataLoader с данными для оценки
15 criterion: nn.Module
16 Функция потерь
17 device: torch.device
18 Устройство для вычислений
19
20 Возвращает:
21 Dict[str, Union[float, np.ndarray]]: Словарь с метриками оценки
22 и результатами предсказаний
23 """
24 model.to(device)
25 model.eval()
26
27 all_targets = []
28 all_predictions = []
29 total_loss = 0.0
30
31 with torch.no_grad():
32 for inputs, targets in data_loader:
33 outputs = model(*inputs)
34 loss = criterion(outputs, targets)
35 total_loss += loss.item() * targets.size(0)
36
37 all_targets.extend(targets.cpu().numpy())
38 all_predictions.extend(outputs.cpu().numpy())
39
40 all_targets = np.array(all_targets).flatten()
41 all_predictions = np.array(all_predictions).flatten()
42
43 mse = mean_squared_error(all_targets, all_predictions)
44 rmse = np.sqrt(mse)
45 mape = mean_absolute_percentage_error(all_targets, all_predictions)
46 mae = mean_absolute_error(all_targets, all_predictions)
47 r2 = r2_score(all_targets, all_predictions)
48
49 avg_loss = total_loss / len(data_loader.dataset)
50
51 return {
52 'loss': avg_loss,
53 'mse': mse,
54 'rmse': rmse,
55 'mape': mape,
56 'mae': mae,
57 'r2': r2,
58 'targets': all_targets,
59 'predictions': all_predictions
60 }
В данной реализации считается множество различных метрик задачи регрессии, для получения наиболее полного понимания о качестве и точности решения задачи.
Для получения всех метрик достаточно выполнить следующий код:
evaluate_model#1test_results = evaluate_model(model, test_loader, criterion, device)
2
3print("Test metrics:")
4print(f"MSE: {test_results['loss']:.3f}")
5print(f"RMSE: {test_results['rmse']:.3f}")
6print(f"MAPE: {test_results['mape']*100:.3f}%")
7print(f"MAE: {test_results['mae']:.3f}")
8print(f"R^2: {test_results['r2']:.3f}")
Этот код выведет результаты тестирования модели.
Метрика |
Значение |
Интерпретация |
|---|---|---|
MSE |
5.281 |
Среднеквадратичная ошибка |
RMSE |
2.298 |
Корень из среднеквадратичной ошибки |
MAPE |
1.066% |
Средняя абсолютная процентная ошибка |
MAE |
0.814 |
Средняя абсолютная ошибка |
R² |
0.987 |
Коэффициент детерминации |
6.6. Визуализация результатов#
Функция visualize_results предназначена для визуализации динамики изменения функции потерь на обучающей и валидационной выборках и построения гистограммы ошибок.
visualize_results# 1def visualize_results(
2 train_losses: List[float],
3 val_losses: List[float],
4 test_results: Dict[str, np.ndarray]
5) -> None:
6 """
7 Визуализирует результаты обучения модели.
8
9 Параметры:
10 train_losses: List[float]
11 Список значений функции потерь на обучающей выборке
12 val_losses: List[float]
13 Список значений функции потерь на валидационной выборке
14 test_results: Dict[str, np.ndarray]
15 Словарь с результатами тестирования модели
16 """
17 _, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 4))
18
19 ax1.plot(train_losses, label='Train Loss')
20 ax1.plot(val_losses, label='Val Loss')
21 ax1.set_xlabel('Epoch')
22 ax1.set_ylabel('Loss')
23 ax1.legend()
24 ax1.grid(True)
25
26 errors: np.ndarray = test_results['predictions'] - test_results['targets']
27 sns.histplot(errors, bins=30)
28 ax2.set_xlabel('Error')
29 ax2.set_ylabel('Frequency')
30 ax2.grid(True)
31
32 plt.tight_layout()
33 plt.show()
Вызовем эту функцию.
visualize_results#1visualize_results(train_losses, val_losses, test_results)
В результате имеем два графика:
Первый — динамика функции потерь на обучении и валидации.
Второй — гистограмма распределения ошибок предсказания.
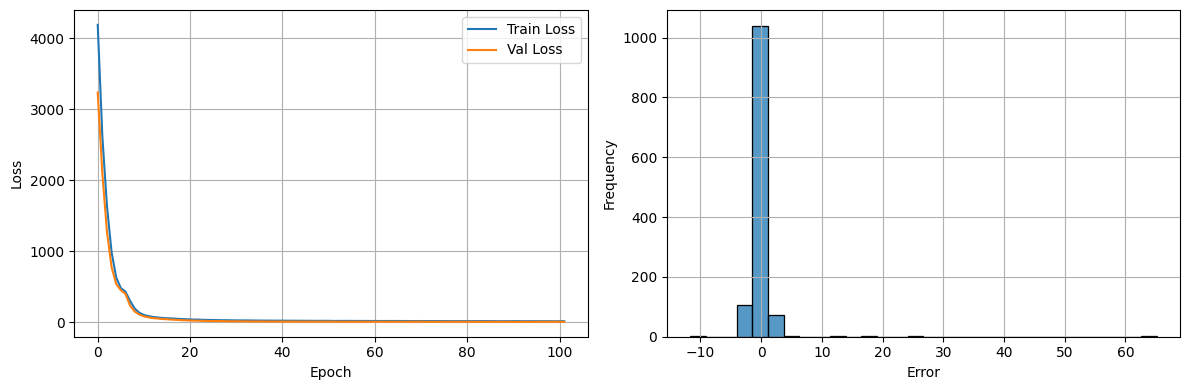
Графики изменения значения функции потерь и распределения ошибок.#
6.7. Экспорт модели в ONNX#
Функция export_to_onnx предназначена для экспорта обученной PyTorch модели в формат ONNX. Функция учитывает необходимости перевода в режим double и учитывает имена входных и выходных параметров.
export_to_onnx# 1def export_to_onnx(
2 model: nn.Module,
3 features: List[str],
4 target: str,
5 output_path: str = "stress_model.onnx"
6) -> None:
7 """
8 Экспортирует PyTorch модель в формат ONNX.
9
10 Args:
11 model: nn.Module
12 PyTorch модель для экспорта
13 features: List[str]
14 Список имен входных признаков
15 target: str
16 Имя целевой переменной
17 output_path: str
18 Путь для сохранения ONNX модели
19 """
20 model.eval()
21 model.double()
22
23 dummy_inputs: Dict[str, torch.Tensor] = {
24 feature: torch.zeros(1, 1, dtype=torch.float64)
25 for feature in features
26 }
27
28 torch.onnx.export(
29 model,
30 dummy_inputs,
31 output_path,
32 input_names=features,
33 output_names=[target],
34 opset_version=12,
35 dynamo = False
36 )
37
38 print(f"Model exported to {output_path}.")
Для конфертации обученной ранее модели необходимо передать ее в объявленную ранее модель и имена признаков и целевой переменной для корректного отображения в REPEAT VISION.
export_to_onnx#1export_to_onnx(model, features, target)
На следующем этапе сохранённая модель будет импортирована на платформу REPEAT VISION в проект газопровода-шлейфа для выполнения междисциплинарного моделирования.
7. Проект газопровода-шлейфа на платформе REPEAT VISION#
На рисунке ниже приведён проект на платформе REPEAT VISION для моделирования газопровода-шлейфа с помощью блоков библиотек Пневматика, Автоматика и Внешние модели. Данная модель газопровода-шлейфа позволяет:
Выполнять расчёт параметров системы сбора на соответствие техническому проекту разработки месторождения;
Определять параметры системы сбора при изменении входных параметров системы подготовки газа и конденсата.
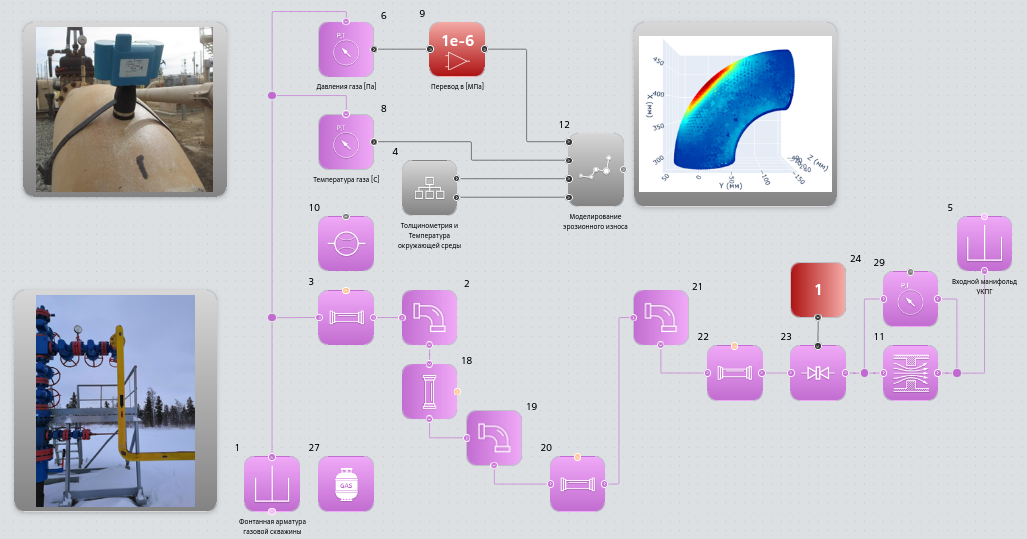
Проект газопровода-шлейфа на платформе REPEAT VISION.#
В рамках единого проекта на основании актуальных данных диагностики технического состояния газопровода-шлейфа также выполняется расчёт напряжений по Мизесу отвода с помощью блока №12 Аппроксимационная модель и импортированной в данный блок модели машинного обучения.
Проект, изображённый выше позволяет:
Выполнять расчётные эксперимены на модели машинного обучения,
В общей междисциплинарной модели выполнять разработку системы управления технологическим процессом добычи газа, учитывая оценку максимальных напряжений по Мизесу в отводе;
С помощью блоков Modbus позволяет создавать цифровые двойники газопроводов для этапа их эксплуатации, подключая к модели системы толщинометрии, системы измерения давлений, температур и расходов газа.
7.1. Результаты расчётных экспериментов#
Динамика уменьшения толщины стенки отвода приведена на рисунке ниже.
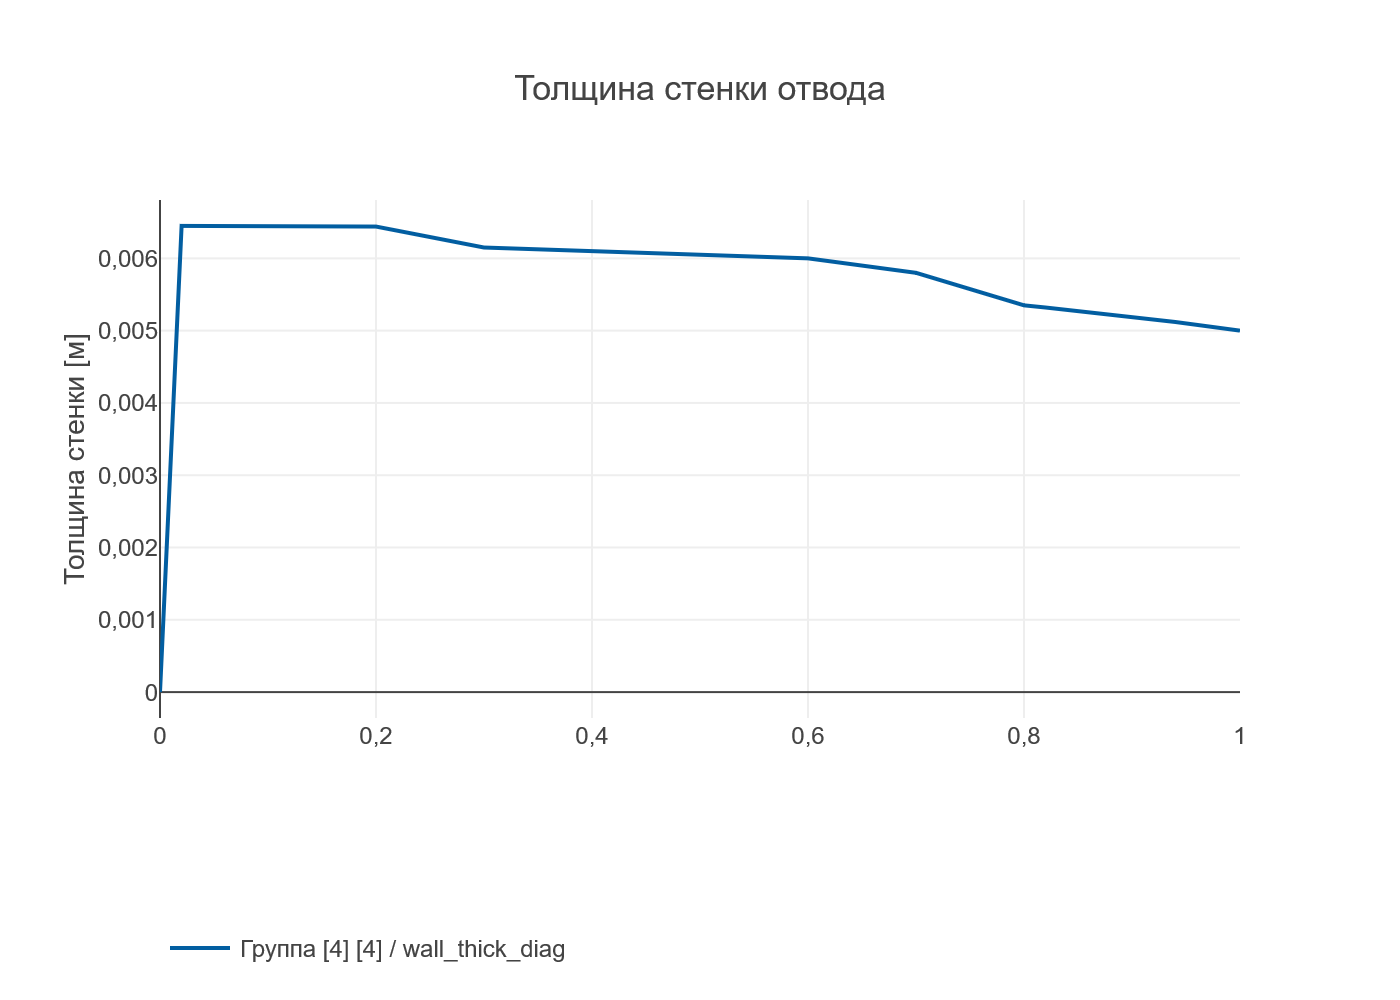
Динамика уменьшения минимальной толщины стенки отвода.#
Уменьшение толщины стенки отвода, а также изменения температуры окружающей среды при сохранении постоянного давления газа приводят к увеличению напряжений в отводе, аппроксимированные результаты которых приведены на следующем рисунке.
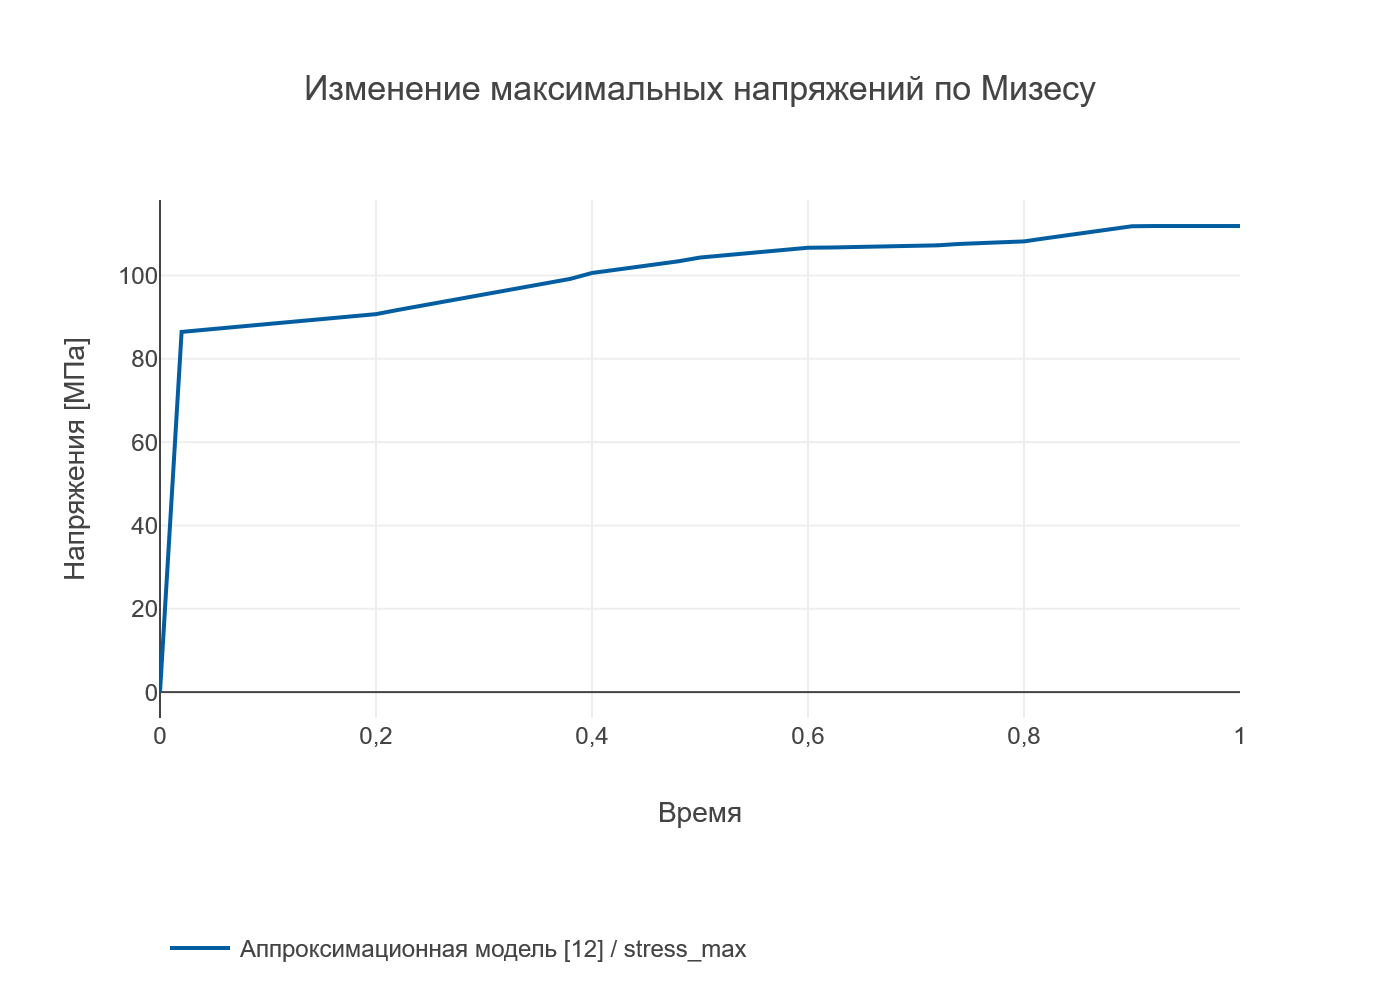
Динамика увеличения максимальных напряжений по Мизесу в отводе.#
8. Выводы#
Интеграция моделей машинного обучения на платформу REPEAT VISION:
Расширяет набор решаемых задач в системном моделировании и в создании цифровых двойников комплексных систем;
Обеспечивает использование МКО и МКЭ моделей больших размерностей, а также моделей, основанных на результатах диагностики эксплуатируемых систем;
По сравнению с прямой интеграцией с внешним инженерным ПО: устраняет риск возникновения ошибок из-за проблем сходимости расчёта МКЭ (МКО) модели, значительно повышает скорость расчёта структурного проекта.